29. 現代のGPUシステムとニューラルレンダリング
此の章は第2部の最後の章で、グラフィックスの行き先を見ます。今日其れを動かしている機械と、グラフィックスの描画に使われ始めたニューラルネットワークです。
第17章はGPUを、ワープ、分岐ダイバージェンス、限られた帯域幅を持つスループット重視の機械として、フォワード及びディファードのレンダラーと共に紹介しました。第12章はイメージベーストレンダリングの最後にNeRFと3Dガウシアンスプラッティングを挙げ、其れらを此処で扱うと約束しました。第20章と第23章は、ニューラルなアップスケーラーとデノイザーについて此の章を指していました。
此の章で其れらの約束を果たします。
前半は現代のGPUシステムです。占有率とレイテンシ隠蔽、明示的なAPI、メッシュシェーダーとGPU駆動レンダリング、ハードウェアレイトレーシング、そしてライティングのアーキテクチャを扱います。
後半はニューラルレンダリングです。1ページで分かるニューラルネットワーク、アップスケーリングとフレーム生成、NeRF、ハッシュグリッド、3Dガウシアンスプラッティング、ニューラルテクスチャ、生成モデルを扱います。
最後に、次に何を学ぶかと第2部の振り返りをして、第30章の模擬試験に進みます。
此れは第2部の内容で検定のシラバスを超えますが、シラバスの2つの項目、リアルタイム3次元CGシステム(第17章)とイメージベーストレンダリング(第12章)を深める物です。
現在の技術は変化が速いです。
実際のハードウェアに関する製品、APIのバージョン、数値は全て「執筆時点(2026年末)」の物として読んで下さい。DLSS、FSR、XeSS、Naniteといった製品名は例として挙げているだけで、推奨ではありません。
線型代数シリーズの第6章の行列・ベクトル積、第7章の転置、第13章のクォータニオン、第28章のボリュームレンダリング、そして20.8節の手前から奥への合成を使います。
29.1 現代のGPUの内部
ワープ、再び
17.2節では、GPUを多数の小さなレーンの集まりとして説明しました。レーンはブロック(ストリーミングマルチプロセッサ又はコンピュートユニット)にまとめられ、32個又は64個の組で足並みを揃えて動きます。此の組がワープ又はウェーブフロントで、分岐が分かれると両方の経路を実行する事も見ました。
シェーダーの速さを決める物が他に2つあります。データが何処にあるかと、同時に準備の出来ているワープが幾つあるかです。
メモリ階層
執筆時点の大まかな桁です(メーカーと世代によって異なります):
| 階層 | 典型的なサイズ | 共有する範囲 | 大まかなレイテンシ |
|---|---|---|---|
| レジスタ | 1ブロックに32ビットレジスタが64K個 | 1スレッド(レーン) | 約1サイクル |
| 共有メモリ(LDS) | 1ブロックに数十KB〜約100 KB | 1ワークグループ | 数十サイクル |
| L1/テクスチャキャッシュ | 同程度、共有メモリと同じ記憶領域の事が多い | 1ブロック | 数十サイクル |
| L2キャッシュ | 数MB〜約100 MB | GPU全体 | 数百サイクル |
| VRAM(GDDR、HBM) | 一般向けカードで8〜32 GB | GPU全体 | 数百サイクル |
レジスタは各スレッド専用で、ブロックのレジスタファイルの大きさは決まっています。1スレッドあたりのレジスタが増えれば、入るスレッドは減ります。
共有メモリ(AMDではLDS)は1つのワークグループのスレッドが共有する作業領域で、リダクション、タイル単位のフィルタ、29.5節のライトリストの為の道具です。
占有率の計算例
レイテンシに対するGPUの答えは第17章と同じです。各ブロックに多くのワープを常駐させ、今のワープが待つ度に準備の出来た別のワープに切り替えます。
占有率(オキュパンシー)は、常駐しているワープの数をブロックが対応する最大数で割った物です。
其れを制限する資源は3つあります。レジスタファイル、共有メモリ、そしてブロックあたりのワープ(及びワークグループ)の数のハードウェア上の上限です。
最近のデスクトップGPUに近い例のブロックを考えます。32ビットレジスタが65,536個、32スレッドのワープが最大48個常駐、ワープスケジューラが4つ(其々12スロット)、共有メモリが100 KBです。
1スレッドあたり個のレジスタを使うシェーダーは1ワープあたり個のレジスタが必要なので、
- :で、上限の48ワープに抑えられ、占有率100%。
- :ワープで、占有率。
- :ワープで、占有率。
コンピュートシェーダーはワークグループ単位で割り当てられるので、共有メモリの方が制限になる事もあります。
256スレッド(8ワープ)で、1スレッドあたり40レジスタ、共有メモリ24 KBを使うワークグループは、レジスタでは個入りますが、共有メモリでは個しか入りません。従って4ワークグループ、32ワープ、66.7%です。
実際のGPUはレジスタと共有メモリの割り当てを決まった単位に切り上げるので、段差はもっと粗くなります。正確な制限要因はメーカーのプロファイラが教えてくれます。
レイテンシ隠蔽の計算例
ワープは幾つあれば十分でしょうか。
簡単なモデルを考えます。1つのスケジューラは1サイクルに1命令を発行します。各ワープはサイクル分の互いに独立な演算を発行し、其の後サイクル掛かるメモリの結果を待ちます。
サイクルの1周の間に、1つのワープはスケジューラをサイクル働かせるので、個のワープが働かせる割合は
で、完全なレイテンシ隠蔽にはスケジューラあたり個のワープが必要です。
図は、です。ワープ2つでは、4つではになります。
もっと現実的なサイクル、では、完全に隠すにはスケジューラあたりワープが必要で、此の例のブロックの12スロットより多いです:
- (スケジューラあたり12ワープ):
- (スケジューラあたり8ワープ):
- (スケジューラあたり4ワープ):
抜け道は2つです。ワープを増やす(レジスタを減らす)か、メモリアクセス1回あたりの独立な仕事を増やす(を大きくする。なら8ワープで)かです。例えば、最初の結果を使う前に複数のテクスチャフェッチを発行します。
但し、占有率が高ければ必ず速い訳ではありません。レジスタを無理に減らすと値が遅いメモリにスピルしますし、帯域幅で制限されたシェーダーは何も得ません。
コンピュートシェーダーと非同期コンピュート
コンピュートシェーダーは、固定機能のステージを持たないワークグループのグリッドを実行します。スレッドはバッファを直接読み書きし、ワークグループ内では共有メモリを通じて協力します。
現代のエンジンでは、フレームの多くがコンピュートです。カリング、ライトリスト、シミュレーション(第26章)、ポストプロセス、TAA、デノイザー、ニューラルネットワーク。
非同期コンピュートは、コンピュートの仕事を2つ目のキューに投入し、シャドウマップの描画の様にレーンを遊ばせるグラフィックスの仕事と重ねられる様にします。節約出来るのは最大でも短い方の仕事の分で、2つはキャッシュと帯域幅を奪い合います。
29.2 明示的なグラフィックスAPI
OpenGLとDirect3D 11は、多くの仕事をドライバーの中に隠していました(リソースの追跡、同期、シェーダーのバリアントの其の場でのコンパイル)。其の殆どは1つのCPUスレッドの上で行われていました。
明示的なAPIであるVulkan(2016年)、Direct3D 12(2015年)及びMetal(2014年)は、此れらの判断をアプリケーションに任せます:
- コマンドバッファ:描画とディスパッチを好きなだけ多くのCPUスレッドで記録し、後でキューに投入します。
- パイプラインステートオブジェクト(PSO):シェーダーと固定機能の状態をまとめて事前にコンパイルするので、フレームの途中でコンパイルは起きません(其れでも起きると、お馴染みのシェーダーコンパイルによるカクつきになります)。
- バリア:アプリケーションが、例えば「此のレンダーターゲットは次にフラグメントシェーダーで読まれる」と宣言します。GPUは書き込みを待ち、キャッシュをフラッシュし、画像のレイアウトを変える事もあります。少なすぎれば画像が壊れ、多すぎればGPUが直列化されます。
- デスクリプタ:バッファやテクスチャが何処にあるかをシェーダーに伝える小さな記録です。描画ごとに数枚のテクスチャをバインドする代わりに、バインドレスレンダリングでは何千ものデスクリプタを1つの大きな配列に入れ、各描画はインデックスだけを渡します。此れが29.3節のGPU駆動レンダリングを可能にします。
計算例(説明用の数値)。 あるシーンが1フレームに10,000回描画し、1回の記録にアプリケーションのCPU時間が2 µs掛かるとします。
1スレッドでは µs = 20 msで、60 fpsのフレーム丸ごとより長くなります。8スレッドなら msです。
代償は責任です。メモリの割り当て、CPUとGPUの同期(フェンスとセマフォ)、全てのバリアがアプリケーションの仕事になります。其の為、此のサイトのOpenGLシリーズはもっと優しいモデルから始めています。
29.3 メッシュシェーダーとGPU駆動レンダリング
メッシュシェーダーとメッシュレット
第6章の古典的なジオメトリパイプラインは、固定機能の入力アセンブラでインデックスバッファを読み、頂点ごとに1回頂点シェーダーを実行します。
メッシュシェーダーは、此の前段を2つのコンピュートに似たステージで置き換えます:
- タスクシェーダー(Direct3Dでは増幅シェーダー)は、クラスタのグループごとに実行され、クラスタを丸ごとカリングしたり詳細度を選んだりして、メッシュシェーダーのワークグループを幾つ起動するかを決めます。
- メッシュシェーダーのワークグループは、小さなメッシュ、つまり其の頂点と三角形を直接ラスタライザーに出力します。
仕事の単位はメッシュレット、隣り合う三角形のクラスタと小さな頂点リストです。
NVIDIAによるTuringのメッシュシェーダーの紹介(2018年9月)は、メッシュレットあたり最大64頂点、126三角形を推奨しました。Direct3D 12はDirectX 12 Ultimate(2020年3月)で、Vulkanはメーカー共通のVK_EXT_mesh_shader(2022年9月)でメッシュシェーダーを加え、Metal 3(2022年)にもあります。
計算例。 8 × 8の格子状の頂点は、64頂点、三角形の1つのメッシュレットになります。
古典的な32ビットのインデックスバッファでは、此れにバイト使います。
メッシュレットは64個のグローバルな頂点インデックス(バイト)、三角形ごとに3つの8ビットのローカルインデックス(バイト)、16バイトのデスクリプタを持ち、合計バイト、元の48%です。
実際のメッシュの節約はもっと小さく(NVIDIAの記事では元のインデックスバッファの典型的に約75%)、より大きな利点は、各メッシュレットがバウンディング球と法線コーンを持ち、丸ごとカリング出来る事です。
GPU駆動のカリング
GPU駆動レンダリングでは、オブジェクトのリストがGPU上にあり、何を描くかをコンピュートシェーダーが決めます:
- コンピュートシェーダーが、全オブジェクトのバウンディング球を視錐台の6つの平面と比べます(6.4節)。
- 残った物を、深度バッファのHi-Zピラミッド(階層Z)と比べます。各テクセルが其の下の最も遠い深度を持つミップチェーンで、19.5節の階層Zのタイルと同じ考えです。オブジェクトの最も近い深度が、覆うテクセルに記録された最も遠い深度より奥なら、隠れています。
- 可視のオブジェクトは、アトミックカウンタを使って描画コマンドをバッファに追加します。
- Vulkanの
vkCmdDrawIndexedIndirectCountの様なインダイレクト描画が、コマンドと其の数をGPUメモリから読むので、CPUは結果を一切見ません。
Hi-Zには、フレームを描く前に深度バッファが必要です。
よく使われる2フェーズの方式では、まず前のフレームで可視だったオブジェクトを描き、其の深度からHi-Zを作り、残りの全てを其れと比べ、新たに見える様になったオブジェクトを2回目のパスで描きます。
計算例:球と平面のテスト。 ビュー空間で、カメラは水平視野角90°で方向を見ています。
左の平面は原点を通り、視錐台の内側を向く単位法線はです(点ではで、内側)。
中心、半径の球は、の時に完全に外側です(此処では):
- 、:で、カリングされます。
- 、:で、残ります(平面をまたいでいます)。
オクルージョンテストでは、40 × 40ピクセルの矩形に投影される球を、Hi-Zのミップレベルで調べます。此のレベルでは1テクセルが64 × 64ピクセルを覆うので、読むのは最大2 × 2テクセルです。
視錐台の部分をコンピュートシェーダーで書くと次の様になります:
struct DrawCommand {
  uint indexCount; uint instanceCount; uint firstIndex; int vertexOffset; uint firstInstance;
};
struct Frustum { float4 planes[6]; uint objectCount; };

StructuredBuffer<float4> spheres;            // xyz = center in view space, w = radius
StructuredBuffer<DrawCommand> allDraws;
RWStructuredBuffer<DrawCommand> visibleDraws;
RWStructuredBuffer<uint> drawCount;          // reset to 0 before the dispatch
ConstantBuffer<Frustum> frustum;

[shader("compute")]
[numthreads(64, 1, 1)]
void cullMain(uint3 id : SV_DispatchThreadID) {
  uint i = id.x;
  if (i >= frustum.objectCount) return;
  float4 s = spheres[i];
  for (int k = 0; k < 6; ++k) {
    if (dot(frustum.planes[k].xyz, s.xyz) + frustum.planes[k].w < -s.w) return;
  }
  uint slot;
  InterlockedAdd(drawCount[0], 1u, slot);
  visibleDraws[slot] = allDraws[i];
}
#version 450
layout(local_size_x = 64) in;
struct DrawCommand {
uint indexCount; uint instanceCount; uint firstIndex; int vertexOffset; uint firstInstance;
};
layout(std430, set = 0, binding = 0) readonly buffer Spheres { vec4 spheres[]; }; // center, radius
layout(std430, set = 0, binding = 1) readonly buffer AllDraws { DrawCommand allDraws[]; };
layout(std430, set = 0, binding = 2) writeonly buffer VisibleDraws { DrawCommand visibleDraws[]; };
layout(std430, set = 0, binding = 3) buffer DrawCount { uint drawCount; }; // reset to 0 before
layout(set = 0, binding = 4) uniform Frustum { vec4 planes[6]; uint objectCount; };
void main() {
uint i = gl_GlobalInvocationID.x;
if (i >= objectCount) return;
vec4 s = spheres[i];
for (int k = 0; k < 6; ++k) {
if (dot(planes[k].xyz, s.xyz) + planes[k].w < -s.w) return;
}
uint slot = atomicAdd(drawCount, 1u);
visibleDraws[slot] = allDraws[i];
}struct DrawCommand {
uint indexCount; uint instanceCount; uint firstIndex; int vertexOffset; uint firstInstance;
};
struct Frustum { float4 planes[6]; uint objectCount; };
StructuredBuffer<float4> spheres; // xyz = center in view space, w = radius
StructuredBuffer<DrawCommand> allDraws;
RWStructuredBuffer<DrawCommand> visibleDraws;
RWStructuredBuffer<uint> drawCount; // reset to 0 before the dispatch
ConstantBuffer<Frustum> frustum;
[numthreads(64, 1, 1)]
void cullMain(uint3 id : SV_DispatchThreadID) {
uint i = id.x;
if (i >= frustum.objectCount) return;
float4 s = spheres[i];
for (int k = 0; k < 6; ++k) {
if (dot(frustum.planes[k].xyz, s.xyz) + frustum.planes[k].w < -s.w) return;
}
uint slot;
InterlockedAdd(drawCount[0], 1u, slot);
visibleDraws[slot] = allDraws[i];
}アトミックカウンタの為、可視の描画の順番はフレームごとに変わります。深度バッファのある不透明なジオメトリでは問題ありませんが、半透明のオブジェクトは今でもソートが必要です(第20章)。
仮想化ジオメトリ
此の考えを突き詰めると、メッシュ全体がクラスタの階層になります。此れが仮想化ジオメトリです。
執筆時点で最もよく知られた例は、SIGGRAPH 2021でBrian Karisが説明したUnreal Engine 5のNaniteです。メッシュを約128三角形のクラスタに分け、隣り合うクラスタのグループを(境界を固定して、ひびが出来ない様にして)まとめて約半分の三角形に簡略化し、新しいクラスタに分け直し、此れを根まで繰り返します。
実行時には、コンピュートのパスが、誤差の投影が約1ピクセル未満になる最も粗いクラスタを選び、其れだけをストリーミングして描きます。
1ピクセルの三角形は2 × 2クアッドの4レーンの内3つを無駄にするので(19.5節)、小さな三角形はコンピュートシェーダーでラスタライズし、深度と三角形のIDを64ビットに詰めてアトミックmaxでビジビリティバッファ(Burns及びHunt、2013年)に書き込みます。後のパスが其れをシェーディングします。
計算例:レベルを選ぶ。 第18章(18.5節)では、垂直視野角60°、1080ラインの画面で、距離にある長さが約ピクセルを覆う事を見ました。
100万三角形の彫像の最も細かいレベルの誤差が1 cmで、1段粗くなる度に三角形が半分、誤差が2倍になるとします。
レベルの誤差は mで、 mの間は1ピクセル未満です。レベル0は9.35 mから、レベル1は18.7 mから、レベル2は37.4 mから、レベル3は74.8 mから使えます。
75 mではレベル3、三角形を、見た目の違い無しに使えます。描く三角形の数は、元のメッシュの大きさではなく、オブジェクトが覆うピクセル数に従います。
仮想テクスチャ
テクスチャも同じ扱いを受けます。仮想テクスチャは巨大なテクスチャをページに分け、最近のフレームで必要になったページだけを物理的なキャッシュテクスチャに置き、ページテーブルでアドレスを変換します。
フィードバックのパス(ハードウェアの対応があればサンプラーフィードバック)が、要求されたページとミップレベルを記録し、足りないページをストリーミングで読み込みます。届くまでは粗いミップで代用します。
計算例。 テクセルのRGBA8の仮想テクスチャは64 GiBです。128 × 128テクセルのページ(各64 KiB)にすると、ページになります。
1920 × 1080のフレームはおおよそ1ピクセルに1テクセル、ページ分を必要とします。境界とミップレベルを含めると数百ページが典型的で、4096 × 4096のキャッシュ(64 MiB)には1024ページが入ります。
29.4 ハードウェアレイトレーシング
2段階の加速構造
12.9節では三角形のBVHを作り、レイトレーシングのAPIが2段階を使う事に触れました。
MicrosoftはDirectX Raytracing(DXR)を2018年3月に発表し、同じ年にレイトレーシングユニットを持つ最初のGPUが出荷されました。KhronosはVulkanのレイトレーシング拡張を2020年11月に確定しました。
どちらも同じ構造を使います:
- BLAS(ボトムレベル加速構造)は、1つのメッシュの三角形(又はプロシージャルな箱)のオブジェクト空間でのBVHです。
- TLAS(トップレベル加速構造)はインスタンスのBVHです。各インスタンスは3 × 4の変換行列、マスク、ID、シェーダーテーブルへのオフセット、BLASのアドレスを持ちます。
レイはまずワールド空間でTLASを辿り、インスタンスに着くと逆変換で其のインスタンスのオブジェクト空間に移ってBLASの中を続けます。
其の為、インスタンシングは殆ど無料です。
計算例。 10,000本の木の森が、50,000三角形のBLASを1つ使います。
インスタンスの記録はDirect3D 12でもVulkanでも64バイト(変換行列48バイト、ID・マスク・オフセット・フラグ8バイト、8バイトのアドレス)なので、インスタンスにはバイト、625 KiBが必要で、其れでシーンには三角形があります。
動くオブジェクトは毎フレーム作り直す小さなTLASの中で変換行列を変えるだけです。変形するメッシュはBLASをリフィット(箱を調整し、木構造は保つ)しますが、形がずれると質が落ちるので、エンジンは時々作り直します。
レイトレーシングパイプライン
レイトレーシングパイプラインには専用のシェーダーステージがあります:
- レイ生成シェーダー:ピクセルごと又はタスクごとに1回起動され、
TraceRay()(GLSLではtraceRayEXT)を呼びます。 - 交差シェーダー:球やSDF(第21章)の様なプロシージャルなジオメトリだけに使います。
- 任意ヒットシェーダー:候補のヒットごとに実行され、典型的には葉やフェンスのアルファテストに使います。
- 最近接ヒットシェーダー:最も近いヒットに対して1回実行され、シェーディングを行い、更にレイを飛ばす事もあります。
- ミスシェーダー:何にも当たらなかった時に実行され、例えば空をサンプリングします。
オブジェクトによって必要なヒットシェーダーが違うので、シェーダーはシェーダーバインディングテーブル(SBT)に並べられ、GPUはレイとインスタンスが与える数値から、どの記録を実行するかを計算します。
DXRでもVulkanでも、ヒットグループの記録のインデックスは
計算例。 あるレンダラーは2種類のレイ、一次レイ(オフセット0)とシャドウレイ(オフセット1)を飛ばすので、ストライドはジオメトリあたり2記録です。
シャドウレイが、インスタンスオフセット6のインスタンスのジオメトリ1に当たると、GPUは記録を実行します。
レイクエリ
DXR 1.1(2020年)以降と、VulkanのVK_KHR_ray_queryでは、どのシェーダーステージからもレイクエリでレイをインラインで飛ばし、結果を自分で調べられます。別のパイプラインと其のシェーダーテーブルは要りません。
フラグメントシェーダーやコンピュートシェーダーでの影のテストの様な、答えが1つの単純な問いに向いています:
RaytracingAccelerationStructure sceneTlas;

// Returns true when something blocks the segment from p towards the light.
bool inShadow(float3 p, float3 dirToLight, float maxDist) {
  RayDesc ray;
  ray.Origin = p;
  ray.TMin = 0.001;
  ray.Direction = dirToLight;
  ray.TMax = maxDist;
  RayQuery<RAY_FLAG_ACCEPT_FIRST_HIT_AND_END_SEARCH | RAY_FLAG_FORCE_OPAQUE> q;
  q.TraceRayInline(sceneTlas, RAY_FLAG_NONE, 0xFF, ray);
  while (q.Proceed()) {}
  return q.CommittedStatus() == COMMITTED_TRIANGLE_HIT;
}
#extension GL_EXT_ray_query : require
layout(set = 0, binding = 0) uniform accelerationStructureEXT sceneTlas;
// Returns true when something blocks the segment from p towards the light.
bool inShadow(vec3 p, vec3 dirToLight, float maxDist) {
rayQueryEXT q;
rayQueryInitializeEXT(q, sceneTlas, gl_RayFlagsTerminateOnFirstHitEXT | gl_RayFlagsOpaqueEXT,
0xFF, p, 0.001, dirToLight, maxDist);
while (rayQueryProceedEXT(q)) {}
return rayQueryGetIntersectionTypeEXT(q, true) != gl_RayQueryCommittedIntersectionNoneEXT;
}RaytracingAccelerationStructure sceneTlas;
// Returns true when something blocks the segment from p towards the light.
bool inShadow(float3 p, float3 dirToLight, float maxDist) {
RayDesc ray;
ray.Origin = p;
ray.TMin = 0.001;
ray.Direction = dirToLight;
ray.TMax = maxDist;
RayQuery<RAY_FLAG_ACCEPT_FIRST_HIT_AND_END_SEARCH | RAY_FLAG_FORCE_OPAQUE> q;
q.TraceRayInline(sceneTlas, RAY_FLAG_NONE, 0xFF, ray);
while (q.Proceed()) {}
return q.CommittedStatus() == COMMITTED_TRIANGLE_HIT;
}
どちらの形もダイバージェンスに悩まされます。光沢反射やGIのバウンスの隣り合うレイは違うマテリアルに当たり、ワープは複数の最近接ヒットシェーダーを順番に実行する事になります(17.2節)。
シェーダー実行の並べ替え(SER)は、次に実行するシェーダーごとにGPUがレイをまとめ直す仕組みで、オパシティマイクロマップ(OMM)は細かい三角形ごとの不透明度を持たせて、アルファテストの葉で任意ヒットの起動を減らします。どちらも2025年3月に発表されたDXR 1.2の一部になりました。
計算例:レイの予算。 2560 × 1440(3,686,400ピクセル)、60 fpsで、ピクセルごとに反射レイ、シャドウレイ、GIのレイを1本ずつ飛ばすと、レイ毎秒、約6.6億本です。
其の為、ゲームはピクセルあたり約1サンプルしか飛ばさず、第23章と第24章のデノイザーとリザーバーによる再サンプリングに頼ります。
29.5 シェーディングレートとライティングのアーキテクチャ
可変レートシェーディング
全てのピクセルが自分専用のフラグメントシェーダーの起動を必要とする訳ではありません。モーションブラーの掛かった部分、霧の向こうの空、VRレンズの周辺部(18.5節)は、粗くシェーディングしても同じに見えます。
可変レートシェーディング(VRS)は2018年からGPUで使える様になり、Direct3D 12とVulkanで公開されています。1 × 2、2 × 1、2 × 2(一部のハードウェアでは2 × 4、4 × 2、4 × 4)のピクセルのブロックごとに1回シェーディングしますが、カバレッジと深度は完全な解像度のままなので、エッジはシャープなままです。
レートは描画ごと、三角形ごと、又は1テクセルが8 × 8か16 × 16ピクセルのタイルを覆う小さなシェーディングレート画像で設定します。
計算例。 2560 × 1440で、画面の40%を2 × 2、20%を2 × 1、40%を完全なレートでシェーディングします。
起動回数の比はで、シェーディングの仕事の40%を節約出来ます。
16 × 16タイルのレート画像はテクセルです。
Forward+、クラスタードシェーディング、ビジビリティバッファ
17.4節ではフォワードとディファードのレンダリングを比べ、タイル単位とクラスタ単位のシェーディングにも触れました。
タイルドフォワード又はForward+(Harada、McKee及びYang、2012年)は、まず深度だけを描き、コンピュートのパスで画面をタイル(例えば16 × 16ピクセル)に分け、各タイルの最小と最大の深度を求め、タイルの小さな視錐台と交わる球を持つライトのリストを作ります。フォワードのパスは自分のタイルのリストだけをループします。
クラスタードシェーディング(Olsson、Billeter及びAssarsson、2012年)は視錐台を深度方向にも分け、深度バッファとは無関係なクラスタと呼ぶ3次元のセルにします。其の為、半透明の面やボリューメトリックフォグにも使えます。
深度方向のスライスは、クラスタが大体立方体に近くなる様に、普通は指数的に配置します:
計算例。 1920 × 1080の画面を64 × 64ピクセルのタイルに分けるとタイルで、から mまでスライスにするとクラスタです。
各スライスは前のスライスの倍の奥行きです。
深度20 mにある半径5 mのライトは15〜25 mにまたがり、から、つまりスライス13と14だけです。従って、ライトが200個あっても、ピクセルは200個ではなく数個だけをループします。
29.3節のビジビリティバッファは3つ目の方法です。ピクセルごとに三角形のIDだけを記録し、三角形をもう一度読んで各ピクセルを1回シェーディングするので、Gバッファより遥かに少ないバイト数しか書きません。
| アーキテクチャ | ライティングのコストが依存する物 | 半透明 | MSAA | ピクセルあたりのメモリ |
|---|---|---|---|---|
| フォワード | ライト × オーバードロー | 自然 | 自然 | 小さい |
| ディファード | ライト × ピクセル | 別のフォワードパス | 高価 | 大きなGバッファ |
| タイルド/クラスタードフォワード | タイル又はクラスタのライト × ピクセル | クラスタードなら自然 | 自然 | 小さい+ライトリスト |
| ビジビリティバッファ | クラスタのライト × ピクセル | 別のパス | 可能 | とても小さい |
検定のポイント
此れらはシラバスの分野8、リアルタイム3次元CGシステム(第17章)に繋がります:
- 占有率はレジスタ、共有メモリ、ブロックあたりのワープの最大数で制限されます。GPUは常駐しているワープを切り替えてメモリのレイテンシを隠します。
- 明示的なAPI(Vulkan、Direct3D 12、Metal)は多くのスレッドでコマンドバッファを記録し、バリアと同期をアプリケーションの責任にします。
- GPU駆動レンダリングでは、コンピュートシェーダーがオブジェクトをカリングしてインダイレクト描画のコマンドを書きます。メッシュシェーダーは個々の頂点ではなくメッシュレットを処理します。
- レイトレーシングのAPIは、三角形のBLASの上にインスタンスのTLASを使います。ディファードシェーディングはGバッファを保存し、クラスタードシェーディングはライトを3次元のセルに振り分けます。
29.6 1ページで分かるニューラルネットワーク
ニューロン、層、MLP
ニューラルネットワークは、パラメータ又は重みと呼ぶ調整可能な数値を沢山持つ関数で、望む事をする様になるまで例を使って調整されます。
其の部品であるニューロンは、入力の重み付き和にバイアスを足し、非線型の活性化関数、最もよく使われるのはReLU、を通します:
ニューロンの層は、行列・ベクトル積にバイアスベクトルを足し、各成分に活性化関数を掛けた物、です。正に線型代数シリーズの第6章の行列・ベクトル積です。
層を積み重ねると多層パーセプトロン(MLP)になり、NeRFが使うのは此のネットワークです:
非線型性が無ければ、2つの層は1つの行列に潰れてしまいます。非線型性があれば、十分に幅の広いMLPは有界な領域上の任意の連続関数を近似出来ます。
学習:損失、勾配、誤差逆伝播
学習は、損失関数を小さくする様にパラメータを調整する事です。例えば出力と望む値の二乗誤差を、多くの例で平均した物です。
勾配降下法は、全てのパラメータを其の微分と逆向きに少しずつ動かします。で、は学習率です。
誤差逆伝播法は、此れらの微分の全てを、連鎖律を使って出力から入力へ層ごとに、1回の逆向きのパスで計算します。
実際の学習はランダムなミニバッチとAdamの様な更新規則を使います。学習済みのネットワークを使う事を推論と言います。
計算例:1つのニューロン、1ステップ。
入力、重み、バイアス、目標、学習率です。
- 順方向:、。損失は。
- 逆方向:。なのでReLUは其のまま通します。従って、。
- 更新:、。
- 確認:、損失はで、25分の1になりました。
何故GPUと相性が良いのか
多くの入力に層を掛けるのは行列・行列積です。64 × 64の層を1920 × 1080のフレームの全ピクセルに掛けると回の浮動小数点演算になり、60 fpsでは小さな層1つで約1.02 TFLOP/sです。
其の為、最近のGPUには低精度の小さな行列のタイルを通常のレーンよりずっと速く掛ける行列演算ユニット(第17章)があり、APIも通常のシェーダーから其れを使える様になりつつあります。執筆時点で、Vulkanには協調行列(cooperative matrix)の拡張があり、Direct3Dのシェーダー用の行列演算(最初は「cooperative vectors」としてプレビューされた物)はShader Model 6.10向けにプレビュー中です。
29.7 アップスケーリング・フレーム生成・デノイズ
ネットワークによる時間方向アップスケーリング
20.6節ではTAAを組み立てました。毎フレームカメラをサブピクセルだけジッタし、前のフレームの出力をモーションベクトルで再投影し、合わなくなった履歴を棄却又はクランプし、ブレンドします。
低い解像度で描き、大きな履歴に蓄積するのが時間方向アップスケーリングで、超解像とも呼ばれます。
難しいのは、TAAが手書きの規則で決めていた事です。エッジ、細い形、ディスオクルージョンの近くで、ピクセルごとに履歴をどれだけ信じるかです。
ニューラルなアップスケーラーは、其の判断を低解像度の連続フレームと高品質な参照画像の組から学習します。入力はTAAと同じ、ジッタされた色、深度、モーションベクトル、ジッタのオフセット、露出です。
執筆時点の例は、NVIDIAのDLSS(2019年の最初の版からニューラルネットワーク、2020年のDLSS 2から時間方向、DLSS 4からトランスフォーマーベース)、AMDのFSR(FSR 3までは手書き、2025年のFSR 4からニューラル)、IntelのXeSSです。第27章では、履歴を使えない単一画像の超解像を扱います。
アップスケーラーには、軸ごとの出力と描画の解像度の比で決まる品質モードがあります。
3840 × 2160の出力の計算例を、執筆時点のAMDのドキュメントにある軸ごとの比で示します(他のアップスケーラーも似た比を使います):
| モード | 軸ごとの比 | 描画解像度 | 描くピクセル |
|---|---|---|---|
| Quality | 1.5 | 2560 × 1440 | 44.4% |
| Balanced | 1.7 | 2259 × 1271 | 34.6% |
| Performance | 2.0 | 1920 × 1080 | 25.0% |
| Ultra Performance | 3.0 | 1280 × 720 | 11.1% |
ピクセルの割合はです。Balancedはピクセルを描き、8,294,400のです。
各出力ピクセルは時間を掛けて複数のサンプルを必要とするので、ジッタの列は比と共に長くなります。AMDのSDKは個の位相を使い、Qualityで18、Performanceで32なので、1周で各出力ピクセルに約8サンプルが入ります。
ネイティブの4Kのフレームが20 ms掛かり、其の内18 msがピクセル数に比例し、アップスケーラー自体が1.5 ms掛かるなら、Performanceモードは約 msです。
フレーム生成
フレーム生成は更に1歩進み、モーションベクトル、オプティカルフロー(第27章)、ネットワークを使って、描いたフレームの間にフレームを丸ごと合成します。
補間では、間のフレームを表示する前に次に描くフレームが必要なので、最新の描いたフレームは待たされます:
計算例。 ゲームは60 fps、16.7 msごとに1フレームを描き、生成には1 ms掛かります。
フレーム生成無しでは、R2は出来た時、33.3 msに表示されます。
2倍の生成では、間のフレームG1½はR2が出来て初めて作れるので msに表示され、R2は表示間隔の半分後の msになります。ディスプレイには毎秒120フレームが表示されますが、遅延は9.3 ms増えます。
マルチフレームのモードは複数のフレームを挟みます。4倍なら60の描いたフレームが240の表示フレームになり、 msごとに1枚です。
ゲームが入力を読むのは相変わらず毎秒60回なので、フレーム生成は滑らかさを改善しますが、応答性は改善しません。又、元のフレームレートが低い程アーティファクトが増えます。メーカーは遅延を減らす技術と組み合わせています。
執筆時点で、NVIDIAのDLSS 4.5(2026年1月発表)は最大6倍(描いた1フレームに対し5枚の生成フレーム)を提供し、AMDとIntelも独自の、そして益々ニューラルになっているフレーム生成を提供しています。
ニューラルデノイズ
23.12節ではGバッファを使うデノイザーからニューラルな物までを扱いました。
ゲームでの流れは、レイトレーシングの生のサンプルのデノイズとアップスケーリングを1つのネットワークで同時に行う事です。例えばNVIDIAのDLSS Ray Reconstruction(2023年)やAMDのFSR Ray Regeneration(2025年)で、更にAMDは、間接光其のものを学習するネットワーク(FSR Radiance Caching)も発表しています。
此れらは全て画像空間で働きます。次の節からは、ネットワークでシーン其のものを表します。
29.8 ニューラル放射輝度場(NeRF)
関数としてのシーン
12.13節では、全光線関数とライトフィールド、つまり全てのレイに沿った放射輝度を写真から記録する物を説明しました。
NeRF(ニューラル放射輝度場。Mildenhall、Srinivasan、Tancik、Barron、Ramamoorthi及びNg、ECCV 2020)は、カメラの位置と向きが分かっている数十〜数百枚の写真から学習した関数としてシーンを保存します:
点と視線方向に対して、体積密度(単位長さあたりどれだけ光を吸収するか。だけに依存)と、放射される色(に依存してもよく、其の為ハイライトが視点と共に動きます)を返します。
はMLPの重みです。
論文では、256ニューロンのReLUの層8つが位置をと特徴ベクトルに変え、128ニューロンの層がもう1つ方向を加えて色を出力します。
レイに沿ったボリュームレンダリング
ピクセルの色は、第28章の放射・吸収モデルを、カメラのレイに沿って手前と奥の境界の間で積分した物です。
NeRFは其れを間隔の個のサンプルで評価します:
はサンプルの周りの区間の不透明度、は其の手前全ての透過率、は其の重みです。
此れは正に20.8節の手前から奥へのアンダー演算による合成で、各サンプルを、アルファが密度から決まる半透明の層として扱っています。
計算例:1本のレイを合成する。
の5つのサンプルで、です。
ネットワークが返す密度のは、アルファが切りの良い値になる様に選んだ、、、、(つまり)で、色は空、明るい灰色、赤、暗い赤、殆ど黒です。背景は白です。
| 1 | 1.0 | 0 | 1 | 0 |
| 2 | 1.5 | 1 | 0.2 | |
| 3 | 2.0 | 0.4 | ||
| 4 | 2.5 | 0.3 | ||
| 5 | 3.0 | 0.5 | 0.05 |
背景に残るのはで、重みと此の残りを足すとになります。
色は:
同じ重みから期待される深度も得られ、深度マップがおまけで付いてきます。
5番目のサンプルは3番目と同じ不透明度ですが、重みは8分の1です。手前で光の90%が既に吸収されているからです。
線型代数シリーズのVec3を使ったコードは次の通りです:
#include <cmath>
#include <cstdio>
#include "linalg.hh"

// Composite n samples along one ray, front to back (section 29.8).
// sigmaDelta[i] = sigma_i * delta_i, color[i] = c_i. Returns the pixel color;
// the transmittance that is left at the end is written to *rest.
Vec3 compositeRay(const float *sigmaDelta, const Vec3 *color, int n, Vec3 background,
                  float *rest) {
  Vec3 c = {0.0f, 0.0f, 0.0f};
  float t = 1.0f;                                   // T_i: nothing in front yet
  for (int i = 0; i < n; ++i) {
    float alpha = 1.0f - std::exp(-sigmaDelta[i]);  // alpha_i
    float w = t * alpha;                            // w_i = T_i alpha_i
    std::printf("i=%d alpha=%.3f T=%.3f w=%.3f\n", i, alpha, t, w);
    c = c + w * color[i];
    t = t * (1.0f - alpha);
  }
  *rest = t;
  return c + t * background;
}

int main() {
  // sigma_i delta_i chosen so that alpha = 0, 0.2, 0.5, 0.75, 0.5
  const float sd[5] = {0.0f, std::log(1.25f), std::log(2.0f), std::log(4.0f), std::log(2.0f)};
  const Vec3 col[5] = {{0.0f, 0.0f, 0.0f}, {0.6f, 0.6f, 0.6f}, {1.0f, 0.2f, 0.1f},
                       {0.8f, 0.1f, 0.1f}, {0.2f, 0.1f, 0.1f}};
  float rest;
  Vec3 c = compositeRay(sd, col, 5, {1.0f, 1.0f, 1.0f}, &rest);
  std::printf("color = (%.3f, %.3f, %.3f), T left = %.3f\n", c.x, c.y, c.z, rest);
}
i=0 alpha=0.000 T=1.000 w=0.000
i=1 alpha=0.200 T=1.000 w=0.200
i=2 alpha=0.500 T=0.800 w=0.400
i=3 alpha=0.750 T=0.400 w=0.300
i=4 alpha=0.500 T=0.100 w=0.050
color = (0.820, 0.285, 0.245), T left = 0.050
描画による学習
式の全てが微分可能なので、NeRFは描画によって学習します。写真からピクセルをランダムに選んで描き(論文では1ステップに4096本のレイ)、二乗誤差で比べ、合成を通してMLPまで誤差を逆伝播します。
ジオメトリは一切与えられません。全ての方向からの写真を説明出来る所に密度が現れます。
論文では100,000〜300,000ステップ、1つのGPUで1シーンあたり1〜2日掛かりました。
階層的サンプリングは、サンプルを大事な所に置きます。粗いネットワークをレイあたり64個の層別サンプルで評価し、重み(合計が1になる様に正規化)を区分的に一定な確率密度として使い、其処から細かいネットワーク用に128個のサンプルを追加で引きます(第23章の重点的サンプリングです)。
此の例のレイでは、0.95で正規化した4つの0でない重みが、128個の細かいサンプルの内約、、、個を引き寄せます。殆どがの表面の近くです。
位置エンコーディング
を其のままMLPに入れると、結果はぼやけます。
勾配降下法で学習するネットワークは低い周波数を先に学び、高い周波数はとてもゆっくりしか学びません。此れがスペクトルバイアス(Rahamanら、2019年)です。
NeRFの対策は位置エンコーディングです。各座標を、周波数が増えていく正弦と余弦で置き換えます:
位置には(で60個の数)、方向には(24個の数)を使います。
Tancikらは「Fourier Features Let Networks Learn High Frequency Functions in Low Dimensional Domains」(NeurIPS 2020)で、此れが効く理由を説明しました。符号化された入力のお陰で、ネットワークは細かい部分を多くの層で作り出す代わりに、速く変化する特徴の組み合わせとして作れるのです。
計算例。 で、はに、はに符号化されます。
入力は0.01しか動いていません。最初の組は殆ど変わりませんが、最後の組は約0.25動きました。高い周波数の特徴のお陰で、近い点同士を簡単に区別出来ます。
此の効果は簡単に再現出来ます。
図は2つの小さなMLP(64個のReLUニューロンの隠れ層2つ、2、9、23周期を含む信号の256サンプルでAdamを3000ステップ)をNumPyだけで学習させた物です。片方にはを、もう片方にはのを入力します:
2つのネットワークは殆ど同じ大きさ(パラメータ4353個と5057個)ですが、符号化した方の誤差は約500分の1です。
周波数が多すぎると逆の問題が起きます。ネットワークが学習サンプルの間に波を作り出してしまいます。
NeRFのコスト
MLPの重みは約60万個(上の層のサイズで、論文の通り5番目の層に入力をもう一度入れると個)で、粗いネットワークと細かいネットワークはレイあたり回評価されます。
従って800 × 800の画像は回のネットワーク評価、約回の浮動小数点演算で、15 TFLOP/sを維持出来るGPUでも1枚に10秒以上掛かります。
何百もの後続の論文が品質(mip-NeRFによるアンチエイリアシング、2021年。境界の無いシーンや動くシーン。再ライティング)と、何よりも速度を改善しました。
29.9 Instant-NGPとハッシュグリッド
大きなMLPは2つの仕事をしています。何処に何があるかを記憶する事と、其れを色と密度に変える事です。
Instant-NGP(Müller、Evans、Schied及びKeller、「Instant Neural Graphics Primitives with a Multiresolution Hash Encoding」、ACM Transactions on Graphics、SIGGRAPH 2022)は、記憶を学習可能な表に移し、残りには小さなMLP(幅64ニューロン)だけを使います。
多重解像度ハッシュエンコーディングは、シーンを覆う個のグリッドを使います。粗い解像度から細かいまで、一定の倍率で大きくなります:
グリッドの各頂点は個の学習可能な数の特徴ベクトルを持ちます。
点を符号化するには、各レベルで点を含むセルの8つの頂点を見つけ、其の特徴を読んで三線型補間します。16のレベルから個の数が得られ、小さなMLPに入ります。
細かいレベルにはメモリが許すより遥かに多くの頂点があるので、其の頂点は個のエントリの表にハッシュされます(論文では〜):
計算例。 、、ではで、解像度は16、22、30、42、58、80、111、153、212、294、406、561、776、1072、1482、2048です。
なら、の間はハッシュ無しで収まります。は収まり、は収まらないので、レベル0〜4は密な表で、レベル5〜15はハッシュされます。
表のパラメータは最大個で、1つ2バイトで32 MiBです(論文では半精度で保存)。
あるハッシュされたレベルの頂点を、桁あふれで一周する32ビットの算術で計算します。を法として、。で、下位19ビットを残すとエントリ329,061です。
隣のは329,058に入ります。なので、方向の隣同士は最下位のビットしか違わず、大抵同じキャッシュラインに入るのです。
#include <cstdint>
#include <cstdio>

// Spatial hash of Instant-NGP (section 29.9): XOR of the integer grid
// coordinates times large primes, modulo the table size T (a power of two).
// The products wrap around modulo 2^32, exactly like unsigned 32-bit math on a GPU.
uint32_t gridHash(uint32_t x, uint32_t y, uint32_t z, uint32_t tableSize) {
  const uint32_t p1 = 1u, p2 = 2654435761u, p3 = 805459861u;
  uint32_t h = (x * p1) ^ (y * p2) ^ (z * p3);
  return h & (tableSize - 1u);  // same as h % T when T is a power of two
}

int main() {
  const uint32_t T = 1u << 19;
  std::printf("y * p2 = %u, z * p3 = %u\n", 5u * 2654435761u, 7u * 805459861u);
  std::printf("h(3, 5, 7) = %u\n", gridHash(3, 5, 7, T));
  std::printf("h(4, 5, 7) = %u\n", gridHash(4, 5, 7, T));
}
y * p2 = 387276917, z * p3 = 1343251731
h(3, 5, 7) = 329061
h(4, 5, 7) = 329058
ハッシュの衝突は一切解決しません。衝突する頂点の殆どは何も無い空間にあって勾配を殆ど受けないので、共有されたエントリは結局表面の近くの頂点の役に立ち、衝突の無い粗いレベルとMLPが残りを片付けます。
論文のLegoのシーンでは、再構成は5秒でPSNR 30.1 dB、1分で35.6 dBに達します。元のNeRFでは何日も掛かっていた物です。
29.10 3Dガウシアンスプラッティング
ラスタライズに戻る
NeRFとInstant-NGPは、今でも何も無い空間の中をレイマーチングしています。
3Dガウシアンスプラッティング(3DGS。Kerbl、Kopanas、Leimkühler及びDrettakis、ACM Transactions on Graphics、SIGGRAPH 2023)は、ボリュームレンダリングのモデルは保ったまま、ネットワークをラスタライザーで描ける何百万個もの明示的な半透明の楕円体で置き換えます。9.5節の点群レンダリングを学習可能にした物です。
各ガウス分布は次の物を持ちます:
- 中心(3個の数)
- 軸ごとのスケール(3個)と、単位クォータニオンによる回転(4個、線型代数シリーズの第13章)
- 不透明度(1個)
- 視点に依存する色を3次までの球面調和関数で、色チャンネルごとに16係数(48個)
合計59個のfloat、ガウス分布1つあたり236バイトです。
論文は、テストセットの学習済みシーン1つあたり411〜734 MB、つまり約170万〜310万個のガウス分布を報告しており、1シーンあたり約30分〜45分の学習の後、リアルタイムで描画します(要旨では1080pで「≥ 30 fps」、テストセットではNVIDIA A6000で134〜154 fps)。
共分散と其の投影
3次元のガウス分布の形は、共分散行列で決まります。
共分散は半正定値でなければならないので、3DGSは其れをの回転行列と対角のスケール行列から作ります:
此れは任意のとで有効なので、勾配降下法は其れらを自由に変えられます。
描く為に、ガウス分布をビュー行列の回転部分でビュー空間に移し、透視投影を中心の近くで其の線型近似、ヤコビ行列(ピクセル座標の微分を並べた2 × 3の行列)で置き換えます:
此処ではビュー空間での中心、はカメラの前方への距離、はピクセル単位の焦点距離です。ピクセル座標は、で、です。
結果は画面上の2次元のガウス分布、スプラットです。
計算例:スケールから画面上の楕円へ。
ガウス分布がビュー軸上の mにあり、スケールは0.02 m、0.005 m、0.01 mで、ビュー軸の周りに30°回転しています。カメラはピクセルです。
軸上ではなので、ピクセル毎メートルで、はの左上の2 × 2ブロックの倍です。
画面上の標準偏差はとピクセルなので、、として:
確認:。
軸から外れるとの3列目が0でなくなり、スプラットは放射方向に引き伸ばされます(課題4)。
参照実装は各スプラットを標準偏差の3倍、此処ではピクセルで囲みます。
評価とブレンド
スプラットの中心からピクセルのオフセットがの所での不透明度は
で、未満の寄与は飛ばします。
計算例の続きで、、ピクセルをとします:
従ってです。
此のピクセルは楕円の長軸に近いので、まだよく覆われています。中心から同じ距離でも楕円を横切る方向のでは、二次形式は3.577で、はに下がります。
ピクセルを覆うスプラットは、NeRFのサンプルと全く同じ様に、20.8節のアンダー演算で手前から奥へブレンドします。
此のスプラット(色)が、、色の別のスプラットの手前にあり、背景が黒なら:
順番を間違えると結果はになります。ソートが大事なのです。
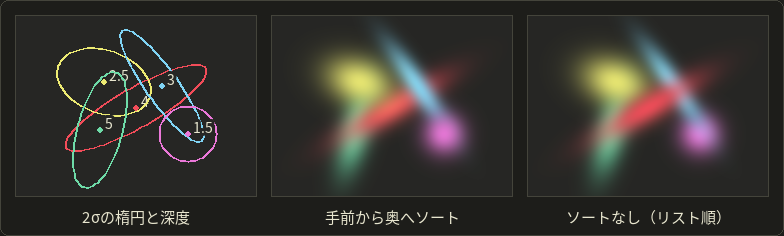
タイルラスタライザー
3DGSは三角形のラスタライザーを使わず、コンピュートで書いた独自のラスタライザーを持っています:
- 全てのガウス分布を投影し、、視線方向に対する球面調和関数の色、覆う画面上の矩形を計算します。
- 各スプラットを、触れる16 × 16ピクセルのタイルごとに複製し、64ビットのキーを付けます。上位ビットがタイルの番号、下位32ビットが深度です。
- 全てのキーを1回のGPUの基数ソートで並べます。此れで各タイルのスプラットが連続し、深度順になります。
- タイルごとに1つのワークグループがリストを手前から奥へ辿り、各ピクセルの累積不透明度が0.9999に達したら止めます。
計算例。 上のスプラットの中心がピクセルで半径12ピクセルなら、は88〜112、は48〜72を覆います。此れは方向のタイル5〜7(、)と方向の3〜4なので、キーは6個です。
ピクセルごとではなくタイルごとにソートするのは近似で(タイルの中で2つのスプラットの順番が入れ替わる事があります)、カメラが回る時の「ポッピング」の原因の1つです。
学習
学習は、カメラの位置と向きを推定する時にSfM(第17章)が作った疎な点群から始め、点ごとに1つのガウス分布を置きます。
NeRFと同じく、学習用の視点を描き、写真と比べ、微分可能なタイルラスタライザーを通して全てのガウス分布の全てのパラメータに誤差を逆伝播します。
100ステップごとに、適応的密度制御が、再構成の足りない領域の小さなガウス分布を複製し、細部を覆いすぎる大きなガウス分布を分割し、殆ど透明なガウス分布を取り除きます。論文は30,000ステップ学習します。
結果は、リアルタイムでラスタライズ出来る明示的で編集可能なプリミティブの集合ですが、大きなファイル、写真から遠い視点でのアーティファクト、焼き込まれたライティングが弱点です。執筆時点では、圧縮、アンチエイリアシング、再ライティング、エンジンでの対応が活発な話題です。
29.11 ニューラルテクスチャ・マテリアル・生成モデル
ニューラルテクスチャとマテリアル
ニューラルテクスチャ(Thies、Zollhöfer及びNießner、「Deferred Neural Rendering: Image Synthesis using Neural Textures」、ACM Transactions on Graphics、SIGGRAPH 2019)は、UVを持つメッシュは其のままに、テクスチャに色ではなく学習した特徴ベクトルを保存します。
メッシュをラスタライズすると画面空間の特徴の画像が得られ、ネットワーク(U-Net)が其れを最終的な絵に変えます。学習したシェーダーによるディファードシェーディングです。
もっと最近の研究は、シェーダーの中で小さなネットワークを使うニューラルマテリアルです。NVIDIAの研究者(Zeltnerら、2024年)は、制作用の多層マテリアルをリアルタイムで評価するネットワークで置き換えました。又、ニューラルテクスチャ圧縮(Vaidyanathanら、2023年)は、マテリアルのテクスチャ一式をコンパクトな潜在テクスチャとデコーダーとして保存し、同程度の品質でブロック形式(第27章)より高い圧縮率を得ます。
29.6節のシェーダー用の行列演算は、此の様な小さなネットワークを通常のピクセルシェーダーで動かす為にあります。
生成モデル
生成モデルは、学習データの分布を学び、其処から新しいサンプルを引きます。
執筆時点で主流の画像生成器は拡散モデルです(Sohl-Dicksteinら、2015年。Ho、Jain及びAbbeel、2020年)。
学習では、きれいな画像にランダムなノイズの強さでガウスノイズを加え、、ネットワークにノイズを予測させます。生成は純粋なノイズから始め、テキストのプロンプトや画像に導かれながら、予測したノイズを数十ステップで取り除きます。
計算例。 で、ピクセル、ノイズならです。ネットワークが正確にを予測すれば、で、きれいな値に戻ります。
此の過程をピクセルではなく圧縮した潜在画像の上で行う事(潜在拡散、Rombachら、2022年)で、一般向けのGPUでも実用的になりました。
CGの制作では既にコンセプトアート、テクスチャ、空、背景を作っており、3次元にも手を伸ばしています。DreamFusion(Pooleら、2022年)は、拡散モデルが描画を尤もらしいと判断するまでNeRFを最適化します。
生成モデルは18.7節の法的な問題も提起します。
其処で説明した日本の考え方では、著作物を学習に使う事は一般に非享受目的の利用として認められますが例外があります。生成物が既存の著作物に類似し依拠していれば、他の複製と同じく侵害になります。そしてAIが自律的に生成した物は著作物ではありませんが、人の創作的寄与は著作物になり得ます。
実務では、モデルと其の出力のライセンスを確認し、特定の作家や作品の表現を狙ったプロンプトを使わず、使う前に出力の類似性を確認し、何を生成したかを記録しましょう。法律は国によって異なり、執筆時点でもまだ発展中です。
29.12 次に学ぶ事と第2部の振り返り
第2部を1つの表で
第1部では検定のシラバスのキーワードを全て扱い、第2部では其の背後にある技術を開いて見ました。
第2部で加わった道具は次の通りです:
| 章 | テーマ | 主な道具 |
|---|---|---|
| 19 | 投影とラスタライズ | どの深度の規約にも使える投影、リバースZ、エッジ関数 |
| 20 | アンチエイリアシングと透明表現 | SSAA、MSAA、TAA。順序非依存の半透明 |
| 21 | メッシュ処理とSDF | QEMによる簡略化、ベイク、スフィアトレーシング |
| 22 | 物理ベースシェーディング | マイクロファセットBRDF、メタリック・ラフネス、IBL |
| 23 | モンテカルロレンダリング | 重点的サンプリング、MIS、パストレーシング、デノイズ |
| 24 | リアルタイムの影・AO・GI | カスケード、PCSS、GTAO、プローブ、ReSTIR |
| 25 | キャラクタアニメーション | デュアルクォータニオン、モーションマッチング、全身IK |
| 26 | 物理シミュレーション | 陰的積分、接触、XPBD、流体 |
| 27 | HDRと画像処理 | トーンマッピング、PQとHLG、周波数領域のフィルタ |
| 28 | ボリュームと高度なNPR | 関与媒質、様式化されたキャラクタと線 |
| 29 | GPUシステムとニューラルレンダリング | 占有率、GPU駆動レンダリング、NeRF、スプラッティング |
全ての章に1つのテーマが通っています。レンダリングの技法は積分(ピクセル上、方向、レイに沿って、時間)の推定であり、各章はサンプルを何処に置くか、どう再利用するか、どんな誤差を受け入れるかを選んで来ました。
NeRFと3DGSは其の最新の例です。第28章のボリュームレンダリングの積分を、第23章で学んだ様にサンプリングし、第20章で学んだ様にブレンドし、勾配降下法で写真に合わせた物です。
次に学ぶ事
- コードを書く。 学習の順番では、此のサイトのGLSLシリーズとOpenGLシリーズが次に来ます。此のシリーズの計算例の多くは、其処でシェーダーや小さなプログラムになります。
- 其の後で明示的なAPI。 OpenGLに慣れたら、Vulkan、Direct3D 12又はMetalで、29.2節と29.3節のコマンドバッファ、バリア、GPU駆動の技法を実際に使って学べます。
- 古典を読む。 Real-Time Rendering(Akenine-Möllerら)、Physically Based Rendering(Pharr、Jakob及びHumphreys、オンラインで無料)、SIGGRAPH、HPG、EGSRのコースノート。
- 機械学習を少し学ぶ。 小さなNeRFやスプラッティングの学習器は、カメラ、サンプリング、合成、最適化に一度に触れられます。そして此の章の「執筆時点」は全て、何が変わったかを確かめるきっかけとして読んで下さい。
次は模擬試験
次の章は、CGエンジニア検定エキスパートの形式に倣った40問の模擬試験、第30章です。
範囲は検定のシラバス、つまり第1部(第2〜18章)で、此の章の様な第2部の内容は含みません。第31章に其の解答と解説、そして此の章を含む全ての章の選択問題の解答があります。
始める前に、第1部の「検定のポイント」と用語の表を見直して下さい。
29.13 まとめ
- 占有率はレジスタ、共有メモリ、ワープの最大数で制限されます。常駐するワープがメモリのレイテンシを隠し、です。コンピュートシェーダーは共有メモリで協力し、非同期コンピュートはキューを重ねます。
- 明示的なAPIは多くのスレッドでコマンドバッファを記録し、パイプラインの状態を事前にコンパイルし、バリアとデスクリプタ(バインドレス)をアプリケーションに任せます。
- メッシュシェーダーはメッシュレットを処理します。GPU駆動のレンダラーはGPU上でカリング(視錐台、2フェーズのHi-Z)してインダイレクトに描きます。仮想化ジオメトリは画面上の誤差でクラスタのLODを選び、仮想テクスチャはページをストリーミングします。
- ハードウェアレイトレーシング:三角形のBLASの上のインスタンスのTLAS、シェーダーバインディングテーブルで選ばれるシェーダー、インラインのレイクエリ。VRSとクラスタードシェーディングは、見える所にシェーディングの仕事を使います。
- ニューラルネットワークは非線型性を挟んだ行列・ベクトル積で、勾配降下法と誤差逆伝播法で学習します。ニューラルなアップスケーラーはTAAの履歴の判断を学習し、フレーム生成は滑らかさを増しますが応答性は増しません。
- NeRF:、、を描画によって学習し、位置エンコーディングと階層的サンプリングを使います。Instant-NGPは記憶を多重解像度ハッシュグリッドに移します。
- 3Dガウシアンスプラッティング:、、タイル単位でソートした手前から奥へのブレンド、適応的密度制御。ニューラルテクスチャはシェーディングにネットワークを入れ、拡散モデルは第18章の注意点の下でコンテンツを生成します。
29.14 用語
| English | 日本語 |
|---|---|
| occupancy | 占有率(オキュパンシー) |
| latency hiding | レイテンシ隠蔽 |
| register, shared memory (LDS) | レジスタ、共有メモリ(LDS) |
| compute shader, workgroup | コンピュートシェーダー、ワークグループ |
| async compute | 非同期コンピュート |
| explicit API | 明示的なAPI |
| command buffer | コマンドバッファ |
| pipeline state object (PSO) | パイプラインステートオブジェクト(PSO) |
| barrier | バリア |
| descriptor, bindless | デスクリプタ、バインドレス |
| mesh shader, task shader | メッシュシェーダー、タスクシェーダー |
| meshlet | メッシュレット |
| GPU-driven rendering | GPU駆動レンダリング |
| indirect draw | インダイレクト描画 |
| hierarchical Z | 階層Z(Hi-Z) |
| virtualized geometry | 仮想化ジオメトリ |
| visibility buffer | ビジビリティバッファ |
| virtual texturing | 仮想テクスチャ |
| BLAS, TLAS | ボトムレベル加速構造(BLAS)、トップレベル加速構造(TLAS) |
| shader binding table (SBT) | シェーダーバインディングテーブル(SBT) |
| ray generation, closest-hit, any-hit, miss shader | レイ生成シェーダー、最近接ヒットシェーダー、任意ヒットシェーダー、ミスシェーダー |
| ray query | レイクエリ |
| variable rate shading (VRS) | 可変レートシェーディング(VRS) |
| tiled forward (Forward+), clustered shading | タイルドフォワード(Forward+)、クラスタードシェーディング |
| neural network, multilayer perceptron (MLP) | ニューラルネットワーク、多層パーセプトロン(MLP) |
| activation function, loss function | 活性化関数、損失関数 |
| gradient descent, backpropagation | 勾配降下法、誤差逆伝播法 |
| training, inference | 学習、推論 |
| temporal upscaling, super-resolution | 時間方向アップスケーリング、超解像 |
| frame generation | フレーム生成 |
| neural radiance field (NeRF) | ニューラル放射輝度場(NeRF) |
| volume density, transmittance | 体積密度、透過率 |
| positional encoding, spectral bias | 位置エンコーディング、スペクトルバイアス |
| hierarchical sampling | 階層的サンプリング |
| multiresolution hash encoding | 多重解像度ハッシュエンコーディング |
| 3D Gaussian splatting (3DGS), splat | 3Dガウシアンスプラッティング(3DGS)、スプラット |
| covariance matrix, Jacobian | 共分散行列、ヤコビ行列 |
| adaptive density control | 適応的密度制御 |
| neural texture | ニューラルテクスチャ |
| diffusion model | 拡散モデル |
29.15 課題
- ★ 29.1節の例のブロック(レジスタ65,536個、ワープ最大48、スケジューラ4つ、共有メモリ100 KB)で、1スレッドあたり96レジスタのシェーダーの占有率を計算して下さい。次に、128スレッドのコンピュートのワークグループが1スレッドあたり48レジスタと共有メモリ20 KBを使う時、ワークグループは幾つ入り、どの資源が制限し、、でのは幾つですか?
- ★ アップスケーラーが2560 × 1440を出力します。Quality(1.5)、Balanced(1.7)、Performance(2.0)の描画解像度とピクセルの割合、及び其々のジッタの列の長さを計算して下さい。ネイティブのフレームが14 ms掛かり、其の内12 msがピクセル数に比例し、アップスケーラーが1 ms掛かるなら、Performanceのフレームは何ms掛かりますか?
- ★★ NeRFのレイにの4つのサンプルがあります。、色は0、0.9、0.5、0.2(1チャンネル)、背景は1です。全ての、、、ピクセルの値、期待される深度(サンプルは)を計算して下さい。階層的サンプリングは64個の細かいサンプルを各サンプルの近くに幾つずつ置きますか?
- ★★ (標準偏差1 cm)の球状のガウス分布が、ビュー空間の mにあり、ピクセルのカメラで見ています。、、画面上の2つの標準偏差を計算して下さい。何故スプラットはもう丸くなく、どちらの方向に引き伸ばされるのでしょうか?
- ★★★ Instant-NGPのあるレベルの解像度が153で、表のエントリが個あります。1つのエントリを平均で幾つのグリッド頂点が共有しますか? 衝突を解決しなくても学習が上手く行く理由と、がキャッシュに役立つ理由を説明して下さい。全てのレベルを1つの共有の表にハッシュしたら何が困るでしょうか?
選択問題
問1 ★ 次のうち、現代のGPUのアーキテクチャについて正しい物はどれか。
| あ | ワープの各レーンは自分専用の命令の流れをフェッチ及びデコードするので、分岐が分かれても余分なコストは掛からない。 |
| い | 占有率が高い程シェーダーは必ず速くなるので、1スレッドあたりのレジスタ数はどんな犠牲を払っても最小にすべきである。 |
| う | 共有メモリ(LDS)はGPU上の全てのワークグループから見え、主にフレームから次のフレームへデータを渡す為に使われる。 |
| え | シェーダーが1スレッドあたりに必要とするレジスタが増えると、1つのブロックに常駐出来るワープが減り、他のワープがメモリを待つ間に切り替えられるワープが少なくなる。 |
| お | 非同期コンピュートとは、GPUがフレームを描いている間に、コンピュートシェーダーをCPU上で実行する事である。 |
問2 ★★ 次のうち、ハードウェアレイトレーシングとGPU駆動レンダリングについて正しい物はどれか。
| あ | BLASは変換行列付きのインスタンスを持ち、TLASは各メッシュの三角形をオブジェクト空間で持つ。 |
| い | レイトレーシングで木を10,000本描くには、其々が三角形のコピーを持つBLASが10,000個必要である。 |
| う | レイクエリを使うと、コンピュートシェーダーやフラグメントシェーダーの様な通常のシェーダーが、レイトレーシングパイプラインのシェーダーバインディングテーブル無しに、インラインでレイを飛ばして結果を自分で調べられる。 |
| え | メッシュシェーダーは、頂点シェーダーと全く同じ様に、固定機能の入力アセンブラによって頂点ごとに1回実行される。 |
| お | GPU駆動レンダリングでは、CPUが全オブジェクトのバウンディング球を視錐台と比べ、可視のオブジェクトごとに描画コマンドを1つ記録する。 |
問3 ★★ 次のうち、ニューラルレンダリングについて正しい物はどれか。
| あ | NeRFはシーンを何百万個もの明示的な3次元ガウス分布として保存し、タイルラスタライザーで描く。 |
| い | 位置エンコーディングは入力から高い周波数を取り除き、ネットワークがより滑らかな関数を学習する様にする。 |
| う | 3Dガウシアンスプラッティングはソートを必要としない。アルファブレンドはどの順番でも同じ結果になるからである。 |
| え | フレーム生成は生成フレームごとにプレイヤーの入力を読むので、高いフレームレートで描画した時と同じだけ入力遅延を減らす。 |
| お | NeRFのボリュームレンダリングでは、サンプルの重みは其のアルファに手前全ての透過率を掛けた物なので、殆ど不透明な面の後ろにあるサンプルは殆ど寄与しない。 |
29.16 実践課題
GPU、NeRF、ガウシアンスプラットを紙の上で動かしましょう。3つのシェーダーの占有率を計画し、放射輝度場の1本のレイを合成し、方眼紙の上でスプラットを描いてブレンドします。
方眼紙(5 mm方眼)、定規、分度器、鉛筆、3色のペン、の計算が出来る電卓を用意して下さい。
パートA:ワープとレイテンシ。
29.1節の例のブロックを使います。レジスタ65,536個、32スレッドのワープが最大48、12スロットずつのスケジューラが4つです。
- 計算する:1スレッドあたり24、56、100レジスタのシェーダーの常駐ワープ数と占有率。
- 描く:シェーダーごとに4 × 12マスの格子を3つ描き、占有率の図の様に、常駐するワープを4つのスケジューラに均等に分けて塗ります。
- レイテンシ:各ワープはサイクルの仕事を発行してからサイクル待ちます。完全に隠すのにスケジューラあたり何ワープ必要か、そして3つのシェーダーのを計算します。
パートB:放射輝度場の1本のレイ。
の5つのサンプルのが、明るさが(1チャンネル)で、背景は1です。
- 計算する:、、を表にし(小数第4位まで)、ピクセルの値と深度を求めます。
- 描く:NeRFの図の様な棒グラフを描きます。は枠の棒、は塗った棒、は階段状の線です(縦軸は1 cm = 0.1)。
- 再サンプリング:32個の細かいサンプルを、正規化した重みに比例して5つのサンプルに分け、合計が32になる整数に丸めます。
パートC:方眼紙の上の1つのスプラット。
スプラットの中心は紙の原点、45°回転した軸に沿った標準偏差は3と1ピクセル、不透明度は0.9です。1マスを1ピクセルとし、は右、は上です。
- 共分散:45°の回転で、其の行列式と逆行列を計算します。
- 描く:2σの楕円を描きます。半軸は6と2で、長い方は45°の線に沿います。ピクセル、、、に印を付けます。
- 評価する:29.10節の式で4つのピクセルのを求めます。どれが一番大きいか、そして何故同じ距離なのにはよりずっと小さいのか。
- ブレンドする:標準偏差2ピクセルの等方的な2つ目のスプラット(不透明度0.6、中心)が手前にあります。ピクセルで其のを求め、青(手前のスプラット)と赤(1つ目のスプラット)を白の背景の上に手前から奥へブレンドします。間違った順番でも繰り返します。
自分で確かめる方法:
- パートA:3つのシェーダーは48、36、20ワープになります。完全に隠すにはスケジューラあたりワープ必要なので、1つ目のシェーダーはレイテンシを全て隠し、他は約82%と45%になります。
- パートB:最後の透過率はと等しく、重みと此の値の合計は1にならなければなりません。一番大きな重みは3番目のサンプルで、深度は1.8より少し小さくなります。
- パートC:は対角が5、非対角が4で、行列式はです。は長軸の上にあってが最大(約0.81)、が最小です。
- パートC:は積なので、どちらの順番でも残る透過率は同じ(約0.13)で、変わるのは色だけです。正しい順番の青のチャンネルは、間違った順番の2倍以上(約0.45対0.19)になります。
コメント(0)
まだコメントはありません。
ログインするとコメント出来ます。