23. モンテカルロレンダリング
第12章ではパストレーシング法に出会いました:目からランダムな経路を飛ばして平均すれば、レンダリング方程式が解ける。
但し、ノイズはでしか減らない。
其の章は其れが上手く行く事を見せ、詳しい話は第2部で、と約束しました。
此の章が其の約束です。
モンテカルロ積分を基礎から組み立て(確率変数、期待値、分散、推定量)、次に全ての本格的なレンダラーが少ないサンプルで綺麗な画像を得る為に使う道具を見ます:逆関数法によるサンプリング、重点的サンプリング(コサイン、GGX、光源)、層化サンプリングと準モンテカルロ法、そして多重重点的サンプリングです。
其の後、パストレーシングを経路の積分として見直し、スループット、ロシアンルーレット、鏡、そして小さなC++のパストレーサーを扱います。
更に先へ進む手法(双方向、メトロポリス、プログレッシブフォトンマッピング)、バイアスと一致性、最後にデノイズと適応的サンプリングです。
第2部は検定の出題範囲を超えますが、此の章は其の項目の1つ、大域照明計算を深める物です:パストレーシング法、モンテカルロ積分、重点的サンプリング、ロシアンルーレットは全て第12章の検定のポイントに出てきました。
最初の幾つかの節で、其れらが何故検定で問われる通りに振る舞うのかを説明します。
前提は第12章のレンダリング方程式、BRDF、光路の表記で、23.5節では第22章のGGX分布を使います。
数学は学校の確率と第12章の積分です。
積分は必ず言葉でも読み上げます。
23.1 何故レンダリングに乱数が必要なのか
第12章(12.7節)のレンダリング方程式を思い出して下さい:
1つのピクセルは、此の式を1回評価すれば済む訳ではありません。
ピクセルの値は、ピクセルの面積(アンチエイリアシング)、レンズ(被写界深度)、シャッターが開いている時間(モーションブラー)についての積分で、更に跳ね返る度に入射方向の半球についての積分、ソフトシャドウの為にはランプの面積についての積分も加わります。
其の1つ1つが次元を増やします:ピクセルの位置で2、レンズで2、時間で1、そして跳ね返り1回毎に新しい方向で2、ランプ上の点で2。
3回跳ね返ると
各次元に10点の格子を取ると回の評価が必要で、1秒に10億本のレイを追跡するGPUでも約3年、其れも1ピクセル分です。
更に悪い事に、台形公式の誤差は1次元ならで減りますが、次元では個の点が本の軸に分けられる為、でしか減りません。
ならで、仕事を2倍にしても結果は9%も良くなりません。
此れが次元の呪いです。
モンテカルロ積分は此の呪いを解きます。
其の誤差は次元に関係なくで減り、サンプル数は幾つでも良く、高次の格子公式が強みを失う被積分関数の不連続(影の境界、物体の輪郭)も気にしません。
4次元を超えれば台形公式に勝ち、レンダリングは4次元より遥かに上にあります。
名前は1940年代のロスアラモスに由来します。
スタニスワフ・ウラム、ジョン・フォン・ノイマン、ニコラス・メトロポリスが中性子の輸送をランダムなサンプリングで計算し(Metropolis and Ulam, "The Monte Carlo Method", 1949)、其れは光の輸送の近い親戚です。
23.2 確率の基本
確率から必要なのは、5つの考え方だけです。
確率変数と期待値
確率変数とは、ランダムな試行から出てくる数です:サイコロの目や、パストレーサーが選ぶ方向です。
其の期待値は、無限回繰り返した時の平均です。
公平なサイコロなら
分散と標準偏差
分散は、値が平均の周りにどれ位散らばるかを測ります:平均からの距離の2乗の期待値です。
サイコロではなので、です。
其の平方根が標準偏差で、、と同じ単位を持ちます。
画像では、ピクセルの推定値の標準偏差こそが、目に見えるノイズです。
(第12章の光の「分散」と同じ言葉ですが、別の意味です。)
連続な確率変数
方向や位置は、或る範囲の中のどんな値にもなり得ます。
其の確率は確率密度関数、pdf で表します:がの周りの小さな区間に入る確率がです。
pdfは負にならず、積分すると1になり、1より大きくなる事もあります(幅0.1の区間に押し込められたpdfの高さは10です)。
左端から迄の積分が累積分布関数、CDF で、となる確率です。
和は積分になります:
一番簡単なのは上の一様分布で、コンピュータの乱数生成器がくれるのは此れです。
平均は、分散はです。
此の章では(具体的な値なら)は常に此の一様乱数を表します。
3つの規則
誤差の解析に必要なのは、次の3つの規則だけです:
- 期待値は線型:。常に成り立つ。
- 定数倍すると分散は2乗倍:。
- 独立な確率変数なら分散は足し算:。
従って、分散の確率変数の独立なコピーを個平均すると
平均は其の儘で、散らばりはで縮みます。
此れが第12章のの法則で、2番目の規則の2乗から来ています。
23.3 モンテカルロ推定量
を推定するには、pdf で独立なサンプルを個取り、次を計算します:
は推定量です:其の値がの推測になる確率変数です。
で割るのが肝心な所です:サンプルが密な所(が大きい)では1つ1つの重みが小さく、疎な所では大きくなります。
何故平均すると正しいのか
1つの項の期待値は
が打ち消し合い、線型性から個の項の平均も同じ期待値を持ちます。
期待値が丁度真の値になる推定量を不偏と言います。
打ち消しには条件が1つ隠れています:となる所では必ず。
一度もサンプルされない領域は、結果から黙って抜け落ちます。
1回の推定はどれだけずれるか
23.2節の規則から、の分散はです。
は1つの項の分散です:
此の章の残りでノイズを減らす為にする事は全て、を小さくする(より良い、23.5節、23.7節、23.8節)、サンプルを上手く独立でなくする(23.6節)、又は後からノイズを取り除く(23.12節)の何れかです。
計算例:正弦の山の面積
積分
は答えが分かっているので、推定量の働きを観察出来ます。
とで一様に選ぶとで、各項はです。
4つの乱数では:
| u | x = πu | sin x | π sin x |
|---|---|---|---|
| 0.62 | 1.9478 | 0.9298 | 2.9210 |
| 0.35 | 1.0996 | 0.8910 | 2.7992 |
| 0.48 | 1.5080 | 0.9980 | 3.1354 |
| 0.81 | 2.5447 | 0.5621 | 1.7658 |
33%大き過ぎます:4つの内3つのサンプルが山の頂上付近に落ちたのです。
期待される散らばりは
(を使いました)。
ならの標準偏差はなので、0.655の誤差は運が悪いものの珍しくはありません:標準偏差の約1.4倍です。
が大きければ推定値は釣鐘型の分布に従い(中心極限定理)、約95%が真の値の以内に入ります:正弦でならです。
レンダラーはを知りませんが、サンプル自身から推定出来ます。
適応的サンプリング(23.12節)が使うのは其れです。
検定のポイント
此の節はシラバスの大域照明計算の項目(第12章12.10節)に繋がります:
- モンテカルロ推定量はを平均する。の所でなら不偏。
- 標準偏差は。サンプルを4倍にするとノイズは半分、100倍で正しい桁が1つ増える。
- という速さは次元に依存しない。其の為、大域照明の高次元の積分にモンテカルロ法が使われる。
23.4 乱数からサンプルを作る
コンピュータがくれるのはの一様な数です。
他の分布は全て其処から作らなければなりません。
逆関数法
主力は逆関数法です:CDF を求め、次の様にします。
何故上手く行くのでしょうか?
となるのは丁度の時で、一様ななら其の確率はです。
従ってのCDFは、つまりpdfはです。
手順はいつも同じです:pdfを積分してを求め、と置き、について解きます。
例1:霧の中の距離。
密度の媒質の中で、光子が相互作用する迄に飛ぶ距離のpdfはです(第12章12.6節のランベルト・ベールの法則を確率として読んだ物)。
なので、を解くと
1メートルあたり、なら m、自由行程の中央値です。
第28章のボリュームのパストレーサーは、正に此の1行を使います。
例2:三角形。
後で上の三角形のpdfが必要になります。
の頂点迄直線的に上がり、又下がる物です:
(三角形の底辺は、高さはなので面積は1です。)
左半分ではで、頂点でになります。
を解くと、では、対称性からではです。
の逆関数が求まらない時は、棄却法が代わりになります:形を囲む簡単な領域で候補を引き、外れた物を捨てるのです。
単位円板の中の点なら、正方形でを引き、なら採用します。
円板は正方形のを占めるので、1点あたり平均1.27個の候補が要ります。
ループの回数が一定しない事が、GPUが逆関数法を好む理由です。
半球上の方向
法線の周りの半球上の方向は、極角(法線から測る)と方位角(法線の周り)で表します。
方向の小さなパッチの立体角はです:地平線近くの輪は、極の近くの輪より長いのです。
立体角についてのpdf は、についてはpdf になり、とを別々に逆関数法でサンプリング出来ます。
半球上の一様サンプリング:。
のpdfは、CDFはなので(も一様なので、単にでも良い)、です。
つまりはで一様で、第12章が使った事実です。
コサイン重み付き半球サンプリング:(なので、で正規化します)。
のpdfは、CDFはなので
局所座標(法線がz軸)ではです:単位円板上の一様な点を、真上に持ち上げて半球に乗せた物です(マレーの方法)。
計算例:、なら、()、で、方向は、pdfは1ステラジアンあたりです。
シーンの中では、法線の周りに外積2回で作った座標系(線型代数 第5章)を使い、局所的な方向をとします。
23.9節のC++のパストレーサーも其の通りにしています。
シェーダーでは、23.7節と23.8節で使う2つの補助関数と一緒に書くと次の様になります:
static const float PI = 3.14159265;

// Cosine-weighted direction in the local frame (z = normal); pdf = cos(theta) / pi.
float3 sampleCosine(float2 u) {
  float r = sqrt(u.x);
  float phi = 2.0 * PI * u.y;
  return float3(r * cos(phi), r * sin(phi), sqrt(max(0.0, 1.0 - u.x)));
}

// Solid-angle pdf of a point picked uniformly on a light of area A (section 23.7).
float lightPdf(float dist, float cosLight, float area) {
  return dist * dist / (area * cosLight);
}

// Power heuristic (beta = 2): MIS weight of technique a against technique b (section 23.8).
float powerHeuristic(float pdfA, float pdfB) {
  float a = pdfA * pdfA;
  float b = pdfB * pdfB;
  return (a + b) > 0.0 ? a / (a + b) : 0.0;
}
const float PI = 3.14159265;
// Cosine-weighted direction in the local frame (z = normal); pdf = cos(theta) / pi.
vec3 sampleCosine(vec2 u) {
float r = sqrt(u.x);
float phi = 2.0 * PI * u.y;
return vec3(r * cos(phi), r * sin(phi), sqrt(max(0.0, 1.0 - u.x)));
}
// Solid-angle pdf of a point picked uniformly on a light of area A (section 23.7).
float lightPdf(float dist, float cosLight, float area) {
return dist * dist / (area * cosLight);
}
// Power heuristic (beta = 2): MIS weight of technique a against technique b (section 23.8).
float powerHeuristic(float pdfA, float pdfB) {
float a = pdfA * pdfA;
float b = pdfB * pdfB;
return (a + b) > 0.0 ? a / (a + b) : 0.0;
}static const float PI = 3.14159265;
// Cosine-weighted direction in the local frame (z = normal); pdf = cos(theta) / pi.
float3 sampleCosine(float2 u) {
float r = sqrt(u.x);
float phi = 2.0 * PI * u.y;
return float3(r * cos(phi), r * sin(phi), sqrt(max(0.0, 1.0 - u.x)));
}
// Solid-angle pdf of a point picked uniformly on a light of area A (section 23.7).
float lightPdf(float dist, float cosLight, float area) {
return dist * dist / (area * cosLight);
}
// Power heuristic (beta = 2): MIS weight of technique a against technique b (section 23.8).
float powerHeuristic(float pdfA, float pdfB) {
float a = pdfA * pdfA;
float b = pdfB * pdfB;
return (a + b) > 0.0 ? a / (a + b) : 0.0;
}23.5 重点的サンプリング
23.3節の分散の式をもう一度見て下さい:。
もし(正のについて)と選べれば、全ての項が丁度になり、分散は0です。
其れは出来ません。
探している答えが必要だからです。
しかし方向は教えてくれます:pdfが被積分関数に似ている程、ノイズは少ない。
其の様にを選ぶのが重点的サンプリングで、第12章は其の極端な例、のコサインサンプリングを見せました。
計算例:再び正弦
に対する3つのの選び方:
| 形 | 各項 | 1サンプルあたりの分散 σ² | |
|---|---|---|---|
| 一様、 | 平ら | 0.9348 | |
| 三角形(23.4節) | 大体sinに似ている | 0.0670 | |
| sinと全く同じ形 | 常に2 | 0 |
三角形の分散(数値計算)は14分の1です:同じノイズに必要なサンプルは14分の1です。
同じ4つの乱数を三角形の逆CDFに通すと:
| u | x | sin x | p(x) | sin x / p(x) |
|---|---|---|---|---|
| 0.62 | 1.7722 | 0.9798 | 0.5550 | 1.7654 |
| 0.35 | 1.3142 | 0.9673 | 0.5326 | 1.8160 |
| 0.48 | 1.5391 | 0.9995 | 0.6238 | 1.6024 |
| 0.81 | 2.1733 | 0.8239 | 0.3924 | 2.0995 |
33%大き過ぎる代わりに9%小さいだけで、4つの項は全て2に近い値です。
理想のpdf は逆関数法でとサンプリング出来、どのサンプルも丁度2を返します。
危険:小さ過ぎるpdf
重点的サンプリングは、事態を遥かに悪くする事もあります。
V字型のpdf 、つまり三角形を逆さにした物を取ります:正弦の頂上で丁度0です。
殆ど全ての所で正なので推定量は不偏の儘ですが、の近くで項が爆発し、は発散します:分散は無限大です。
個のサンプルの平均は其れでも2.000になりますが、標本分散(あたしの実行では32)はいつまでも落ち着かず、画像では稀に極端に明るいピクセルとして現れます。
規則:が小さい所でが大き過ぎるのは構わない(サンプルの無駄になるだけ)が、が大きい所でが小さ過ぎては絶対に駄目。
レンダラーでの重点的サンプリング
レンダリング方程式の被積分関数は積です。
入射光は未知(再帰で計算する物)なので、分かっている因子で重点的サンプリングをします:
- BSDFサンプリング:出来るだけにする。ランバート面ならコサインサンプリングで、。
- 光源サンプリング: ランプから直接届く光(23.7節)。
- 環境マップのサンプリング:HDRの空(第12章12.13節)の明るさの2次元の表を逆関数法で使う。行のCDF、次に選んだ行の中のピクセルのCDFで、太陽に殆どのサンプルが行く様にする。
第12章の一様な空からの放射照度なら、半球上の一様サンプリングの項はで、コサインサンプリングでは毎回です。
GGXローブのサンプリング
光沢のあるマイクロファセットBRDF(第22章)は鏡面方向の周りに集中していて、コサインサンプリングは其処に殆どサンプルを送りません。
古典的な方法(Walter、Marschner、Li、Torrance、2007年)は、ハーフベクトル(マイクロファセットの法線)をGGX分布からサンプリングし、視線方向を其の周りで反射させます。
をGGXの幅のパラメータとすると(多くのエンジンはとします):
此のpdfは半球上で積分すると1になり(は其の様に正規化されています)、CDFの逆関数から
次にです。
の周りの反射は角度を2倍にするので、についてのpdfにはヤコビアンが付きます:
計算例。
、法線の真上から見て()、:
(此処ではなのでです。)
反射方向は法線からの方向に出て行きます。
ハーフベクトルの半分は法線から16.70°以内、90%は41.99°以内()に入ります:ローブはサンプリングされ、空っぽの半球はされません。
今日の改良版は、視点から実際に見える法線だけをサンプリングします(VNDFサンプリング、Eric Heitz、2018年)。
特に斜めから見る時に効きます。
見た目の違い
第12章の箱を、同じサンプル数(1ピクセルあたり16)で、拡散面での跳ね返りに3つのサンプリング方法を使ってパストレーシングした物です。
RMS誤差は1ピクセルあたり2048サンプルの参照画像に対して測りました:
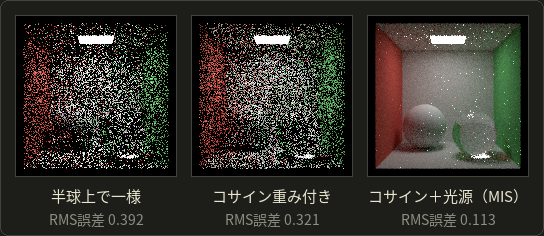
コサインサンプリングは誤差を18%減らします:被積分関数の因子の1つに合っているからです。
大きく跳ぶのはランプも直接サンプリングした時(23.7節)で、最初の2枚のノイズの殆どは、小さなランプを運良く見つけた経路から来ているのです。
23.6 層化サンプリングと準モンテカルロ法
重点的サンプリングは、サンプルが平均してどこに行くかを変えます。
もう1つのレバーは、どれだけ均等に散らばるかです。
独立な乱数のサンプルは固まったり隙間を空けたりします。
23.3節の4つの内3つが山の頂上付近に集まった様にです。
層化サンプリング
層化サンプリングは、領域を個の等しい部分(層)に分け、其々にランダムなサンプルを1つずつ置きます。
1次元では、サンプル(0から数える)はです。
同じ4つの数では:
| k | (k + u)/4 | x | π sin x |
|---|---|---|---|
| 0 | 0.1550 | 0.4869 | 1.4700 |
| 1 | 0.3375 | 1.0603 | 2.7410 |
| 2 | 0.6200 | 1.9478 | 2.9210 |
| 3 | 0.9525 | 2.9924 | 0.4671 |
で、5%小さいだけです。
山の4分の1毎に丁度1つのサンプルが入るので、固まりようがありません。
推定値は不偏の儘で、分散は独立なサンプルより大きくなる事がありません。
滑らかな関数なら、誤差は1次元で、次元でで減ります。
第2章(2.7節)の規則的なのスーパーサンプリングの格子は、各サンプルをセルの中でランダムに動かすと層化サンプリングになります。
此れをジッターサンプリングと呼びます。
測ったRMS誤差(各点4000回)は予測通りです:1024サンプルで一様は0.030()、三角形は0.0081()、層化サンプリングは0.00006。
重点的サンプリングは線を下にずらし、層化は傾きを急にします。
両者は組み合わせられます:の値を層化してから、逆CDFに通せば良いのです。
問題は又しても次元です。
次元の完全なジッター格子には個のサンプルが要ります:17次元で各軸に2層なら1ピクセルあたり131,072サンプルです。
其の為レンダラーは次元の小さな組(ピクセル、レンズ、跳ね返り毎)を別々に層化し、組同士の組み合わせを入れ替えます。
ラテン超方格やマルチジッターサンプリングの考え方です。
準モンテカルロ法
準モンテカルロ法(QMC)はランダムさを捨て、点が幾つでも空間を均等に埋める様に設計された決定的な低食い違い量列を使います。
点集合の食い違い量(ディスクレパンシー)は、其の最悪の偏りです:原点を角とする全ての箱について、中に入る点の割合と箱の体積の差の最大値です。
コクスマ・フラウカの不等式は誤差を(の変動)×(食い違い量)で抑え、良い点列は約、殆どに達します。
部品は基数のラディカルインバース(radical inverse)です:番号を進法で書き、小数点を挟んで桁を鏡写しにします。
2進法では、、、。
2進法の列がファン・デル・コルプット列です:新しい点は、残っている一番大きな隙間の1つに入ります。
ハルトン列(John Halton、1960年)は次元毎に違う素数を基数にします:点は(の基数2のラディカルインバース、基数3の其れ、基数5の其れ、…)です。
計算例、2次元の点6:2進では上の通り0.375、なので、点はです。
3進の最初の8つはです。
ソボル列(Ilya Sobol、1967年)は全ての次元で2進法を使い、次元毎に違う「方向数」をXORで組み合わせます。
ハルトン列(大きな基数では規則的な縞が出ます)より遥かに多くの次元で質を保ち、ビット演算で速いので、本格的なレンダラーでは普通こちらが選ばれます。
決定的な点列では誤差の見積もりが出来ません。
乱択準モンテカルロ法は、全ての点に同じランダムなずれを足して端で折り返したり(クランリー・パターソン回転)、桁をランダムに入れ替えたり(オーウェンのスクランブル)します。
すると各点は一様になって推定量は再び不偏になり、点は均等な広がりを保ちます。
滑らかな2次元の被積分関数で、2000回の乱択について測ったRMS誤差は:
| N | 独立な乱数 | ジッター格子 | ランダムにずらしたハルトン列 |
|---|---|---|---|
| 16 | 0.0414 | 0.0109 | 0.0180 |
| 64 | 0.0209 | 0.00269 | 0.00473 |
| 256 | 0.0102 | 0.00069 | 0.00132 |
| 1024 | 0.0052 | 0.00017 | 0.00041 |
1024サンプルでは、ずらしたハルトン列は乱数より13倍正確です。
此処でジッター格子が勝つのは、2次元でが平方数だからに過ぎません。
ハルトン列はどんなでも使え、1サンプルずつ追加出来、多くの次元に広げられます。
1ピクセルあたり1、2サンプルしか取らないリアルタイムのレンダラーでは、残る誤差がどう見えるかの方が大事です:ブルーノイズのパターンは誤差を細かいざらつきに変え、目にもデノイザーにも塊より扱い易くします。
23.7 光源のサンプリング
コサインサンプリングでも何故あれ程ノイズが出たのでしょうか?
ランプが小さく、コサインでサンプリングした方向が滅多に当たらないからです。
ランダムな反射は何回ランプを見つけるか
0.6 m × 0.6 mの四角いランプ( m²、第12章の箱のランプ)、放射輝度の中心の、2 m真下の床の点を考えます。
数値積分すると、ランプからの放射照度は W/m²です。
コサインでサンプリングした方向がランプに当たる確率は
ランプを見るのは跳ね返りの2.8%だけで、推定値は0か大きな値かのどちらかになります。
最悪の種類のノイズです。
点光源(立体角0)なら、確率は丁度0です。
光源上の点をサンプリングする
光源サンプリングは此れを逆にします:ランプ上の点を面積について一様に選び()、其処へシャドウレイを送ります。
此れが次イベント推定(NEE)で、第12章のパストレーサーも既にしていました。
方向とランプの面積は、次の図の幾何で結ばれます:
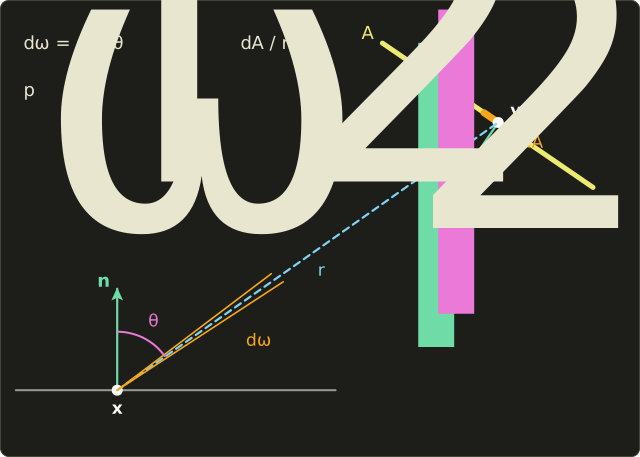
第12章の立体角と同じく、パッチは遠い程、又傾いている程小さく見えます。
従って面積についてのpdf は、での立体角については
で、1サンプルの直接光の推定量は
はシャドウレイが遮られなければ1、遮られれば0です。
計算例。
ランプの下の床の点で、床はの白なのでです。
ランプの中心のサンプル:、どちらのコサインも1で、放射照度の部分は。
床の点から見ての角のサンプル:、で、放射照度の部分は。
どのサンプルも此の2つの値の間に入り、真の値1.2234に近くなります。
コサインサンプリングの「0か、36倍大き過ぎるか」とは大違いです。
中心のサンプルからの反射放射輝度はです(真の値は)。
立体角で言えば、中心方向の光源のpdfは1ステラジアンあたり、コサインサンプリングは其処でです:光のある所に35倍多くのサンプルが行きます。
沢山の光源
ランプが何千個もあるなら、確率で1つをランダムに選び、其の寄与をで割ります。
1段上のの規則です。
電力に比例させると、100 W、50 W、10 Wのランプはで、弱いランプが選ばれた時は其の寄与が16倍されます。
本格的なレンダラーは明るくて近い光源を優先する木構造(「ライトBVH」)から光源を選び、ReSTIR(第24章)は良い光源サンプルをピクセル間やフレーム間で使い回し、何百万もの光源をリアルタイムで扱います。
23.8 多重重点的サンプリング
光源サンプリングは、小さなランプの下の艶消しの床には最適です。
では床を殆ど鏡にし、ランプを巨大な窓にしてみましょう。
光源のサンプルは窓全体に散らばり、殆どは鋭いBRDFのローブの外(値は殆ど0)、稀に1つが中(巨大な値)に入ります。
一方BSDFサンプリングは全てのレイをローブの中に送り、其処では大きな窓に簡単に当たります。
どちらの手法が勝つかは材質と光源次第で、本物のシーンには全ての組み合わせが同時にあります。
2つの手法を組み合わせる
多重重点的サンプリング(MIS)は1995年にEric VeachとLeonidas Guibasが発表した物で("Optimally Combining Sampling Techniques for Monte Carlo Rendering")、両方の手法を使い、各サンプルを其の点で其の手法がどれだけ得意かで重み付けします。
手法からpdf で個のサンプルを取ると:
となる全てので重みの和が1、なら(且つの所ではなら)、此れは不偏です。
証明は1行です:期待値は。
問題は重みの選び方です。
VeachとGuibasは2つのヒューリスティックを提案しました:
普通はです。
其の点でpdfが高い手法(そういう点をよく見つける手法)は大きな重みを貰い、運だけで見つかったサンプル(pdfが低く、が巨大)は小さな重みを貰います。
其れこそが、放っておけばファイアフライになるサンプルです。
バランスヒューリスティックでは各項がになり、全てのサンプルが1つの混合pdfから来た様に見えます。
Veachは、其の分散が他のどんな重み付けよりも高々しか大きくならない事を証明しました。
パワーヒューリスティックは重みを鋭くし、1つの手法が明らかに正しい時に効きます。
多くのレンダラーが使うのは此方です。
計算例:重み
23.7節の艶消しの床で、ランプの中心への方向、各手法から1サンプルずつ:、。
此処では明らかに光源サンプリングが正しい手法で、MISは殆ど全ての重みを其方に渡します。
光沢のある面で、同じ様なランプについて、或る方向で、の場合:
どちらの場合も重みの組は足して1になり、其れが推定量を不偏に保ちます。
計算例:分散
1次元の「フラットランド」版で、効果を測る事が出来ます。
20°の周りの幅の釣鐘型の光沢ローブ(BSDFサンプリングが正確に従う)を、角度の或る区間を覆うランプ(光源サンプリングが一様にサンプリングする)が照らし、被積分関数はランプの中でローブ×コサインです。
全部で2サンプル(1つの手法で2つ、又はMISで1 + 1)の時の、正確な相対標準偏差(標準偏差 / 真の値):
| 場合 | BSDFサンプリングのみ | 光源サンプリングのみ | MISバランス | MISパワー |
|---|---|---|---|---|
| 広いローブ(s = 30°)、小さなランプ(10°) | 180% | 1.3% | 30% | 4.8% |
| 鋭いローブ(s = 3°)、大きなランプ(60°) | 1.4% | 152% | 34% | 22% |
単独の手法は、一方の場合では非常に良く、もう一方では酷い物です。
MISは決して酷くなりません:正しい手法(2サンプルの代わりに1サンプル)には負けますが、150〜180%という大惨事を無くし、どちらの場合もパワーヒューリスティックがバランスヒューリスティックに勝ちます。
レンダラーは各ピクセルがどちらの場合なのかを知らないので、此の頑健さこそが必要なのです。
中間の場合(0°の周りの幅12°のローブ、−5°から35°のランプ)の2つのpdfと重みです:
ローブが高い所ではBSDFサンプリングが重みを取り、ローブの縁に向かって光源サンプリングが引き継ぎます。
重みが交わるのは9°、丁度となる所です。
MISには1サンプル版もあります:確率で手法を選び、1サンプル取ってを使います。
材質の層(拡散のベースかクリアコートか)を選ぶ時に便利です。
23.9 パストレーシングの詳細
パストレーサーが何を推定しているのかを考え、23.10節の手法を組み立てる為に、Veachの博士論文("Robust Monte Carlo Methods for Light Transport Simulation"、スタンフォード大学、1997年)はレンダリング方程式を経路についての普通の積分に書き直しました。
経路積分
長さの経路は点の並びです:はカメラ上、は光源上、他は面の上にあります。
ピクセルの値は
全ての経路の長さについての、全ての頂点の位置についての積分です。
測定寄与関数は、放射される光、跳ね返る毎のBSDF、カメラの感度、そして隣り合う頂点の間の幾何項を掛け合わせた物です:
は23.7節のの面と面の版です:2つの点がお互いをどれだけ「見ている」か。
2 m離れ、コサインが0.8と0.6で遮る物の無い2点では(1 m²あたり)です。
(第12章のラジオシティ法の形態係数は、此のをで割って2つのパッチで平均した物です。)
ヘックバートの表記にも正確な意味が付きます(LDSEは頂点が光源、拡散面、鏡面、目の経路の集合)。
そして全てのレンダリングアルゴリズムは、経路をサンプリングし、を其れを作った確率密度で割る方法の違いなのです。
スループット
パストレーサーは各頂点で点ではなく方向を選びます。
立体角のpdf の方向は、次の頂点に面積のpdf を与え(又しても23.7節)、其れがの同じ因子と打ち消し合って、スループットの更新式が残ります:
はカメラで1から始まり、経路が放射される光に届く度に、ピクセルはを受け取ります。
コサインサンプリングするランバート面では因子はアルベドなので(23.5節)、回の拡散反射の後はです。
ロシアンルーレットと其の代償
経路を決まった最大の深さで止めるとバイアスが出ます:もっと跳ね返る必要のある光が失われるのです。
ロシアンルーレット(1990年にJames ArvoとDavid Kirkがグラフィックスに持ち込みました)は確率で続けてをで割り、其れ以外では止めます。
残りの寄与は、確率でに、其れ以外では0になります:
不偏ですが、只ではありません。
増える分散は
第12章の例(、)ではで、其の代わりに仕事の30%を省けます。
大事なのは効率です:残りの寄与が小さい経路を止める時、ロシアンルーレットは得になります。
其の為、普通は何回か跳ね返った後でとします:暗い経路は間引かれ、生き残った経路はスループットが1近く迄持ち上げられます。
一定のなら、経路は平均回跳ね返ります(なら5回)。
小さなパストレーサー
答えの分かっているシーンでの、C++のパストレーサーの中心のループです:カメラは閉じた球の中にあり、球の内壁はアルベドのランバート面で、放射輝度で光っています。
第12章の等比級数(12.7節)から、正確な答えは、なら5です。
ループは球との交差を求め、放射にスループットを掛けて足し、コサイン重み付きの方向をサンプリングし、スループットにを掛け、ロシアンルーレットをします。
線型代数シリーズのlinalg.hhのVec3、dot、cross、normalizeを使います:
#include <algorithm>
#include <cmath>
#include <cstdio>
#include <random>
#include "linalg.hh"

// A camera at the center of a closed sphere (radius 1). The inside wall is
// Lambertian with albedo rho and emits radiance Le. Exact answer: Le / (1 - rho).
const float PI = 3.14159265f;
std::mt19937 gen(7);
float rnd() { return (gen() >> 8) * (1.0f / 16777216.0f); }

// Cosine-weighted direction around the unit normal n (pdf = cos / pi).
Vec3 sampleCosine(Vec3 n) {
  float u1 = rnd(), u2 = rnd();
  float r = std::sqrt(u1), phi = 2.0f * PI * u2;
  Vec3 a = std::fabs(n.x) > 0.9f ? Vec3{0, 1, 0} : Vec3{1, 0, 0};
  Vec3 t = normalize(cross(a, n));
  Vec3 b = cross(n, t);
  return r * std::cos(phi) * t + r * std::sin(phi) * b + std::sqrt(1.0f - u1) * n;
}

// The core loop of a path tracer. maxDepth < 0 means: no limit, Russian roulette instead.
float radiance(Vec3 o, Vec3 d, float rho, float Le, int maxDepth, int *bounces) {
  float L = 0.0f, beta = 1.0f;  // beta = path throughput
  for (int depth = 0;; depth++) {
    float b = dot(o, d), c = dot(o, o) - 1.0f;  // hit the sphere from inside
    Vec3 p = o + (-b + std::sqrt(b * b - c)) * d;
    Vec3 n = -1.0f * p;                         // inward unit normal
    L += beta * Le;                             // emission at the hit
    *bounces = depth + 1;
    if (maxDepth >= 0 && depth >= maxDepth) break;
    d = sampleCosine(n);
    beta *= rho;                                // f cos / p = (rho/pi) cos / (cos/pi)
    if (maxDepth < 0) {                         // Russian roulette
      float q = std::min(beta, 1.0f);
      if (rnd() >= q) break;
      beta /= q;
    }
    o = p + 1e-4f * n;
  }
  return L;
}

void run(const char *name, float rho, int maxDepth) {
  const int paths = 1000000;
  double sum = 0, sq = 0, steps = 0;
  for (int i = 0; i < paths; i++) {
    int k = 0;
    double v = radiance({0, 0, 0}, {0, 0, -1}, rho, 1.0f, maxDepth, &k);
    sum += v;
    sq += v * v;
    steps += k;
  }
  double mean = sum / paths, sd = std::sqrt(std::max(0.0, sq / paths - mean * mean));
  printf("%-22s mean = %.4f  sd per path = %.3f  hits per path = %.3f\n", name, mean, sd, steps / paths);
}

int main() {
  float rho = 0.8f;
  printf("exact Le / (1 - rho)   = %.4f\n", 1.0f / (1.0f - rho));
  run("max depth 4", rho, 4);
  run("max depth 16", rho, 16);
  run("Russian roulette", rho, -1);
  return 0;
}
exact Le / (1 - rho)   = 5.0000
max depth 4            mean = 3.3616  sd per path = 0.000  hits per path = 5.000
max depth 16           mean = 4.8874  sd per path = 0.000  hits per path = 17.000
Russian roulette       mean = 5.0006  sd per path = 4.478  hits per path = 5.001
3行でバイアスと分散が分かります。
5回当たった所で止めると、此の対称なシーンではノイズは0ですが、33%暗過ぎます()。
17回でも2%暗過ぎます()。
ロシアンルーレットは平均で正しく(5.0006、100万本の経路の標準誤差は)、1本あたり5回、回しか当たりません。
しかし1本1本の経路はノイズを持ちます:其の値は当たった回数で、標準偏差の幾何分布の確率変数です。
此れが第12章(12.13節)のホワイトファーネステストで、真面目なレンダラーは皆此れを走らせます。
鏡とガラス:デルタ分布
完全な鏡のBRDFはデルタ分布です:1つの方向以外では0で、合計は(フレネル反射率)。
パストレーサーは鏡面方向を取り、を其の極限に置き換えます(第12章のレンダラーの様に確率とで反射か屈折かを選ぶ時は1に)。
其処では光源サンプリングは役に立たない(ランプ上のランダムな点が丁度鏡面方向にある確率は0)ので、鏡面の頂点ではNEEを飛ばし、鏡面反射の直後にランプに当たった時は、其の放射をMISの重み1で数えます。
此の章のレンダラーでは、フラグ1つです。
此れで第12章のガラス球の下の頑固な斑点の理由が分かります:目から辿るコースティクスの経路LSDEは、床で跳ね返ってガラスを通り、小さなランプに偶然当たらなければならず、点光源なら其れは絶対に起きないのです。
LS+DS+Eの経路(鏡に映ったコースティクス、水面越しに見るプールの底)は、拡散面の頂点で繋ぐ全ての手法にとって最も難しい物です。
パストレーサーの中のMIS
23.7節と23.8節を合わせると、鏡面でない全ての頂点は2つの事をします:
at a diffuse or glossy vertex x (throughput beta, outgoing direction wo):
    light sample:  pick y on a light, pdf pL (solid angle)
                   if visible: add beta * f(wo, wi) * cos * Le / pL * w(pL, pB(wi))
    BSDF sample:   pick wi with pdf pB, beta *= f(wo, wi) * cos / pB
                   trace the ray; if it hits a light:
                       add beta * Le * w(pB, pL(hit))
                   otherwise continue the path from the hit
w(a, b)は23.4節のシェーダーのパワーヒューリスティックです。
此れが23.5節の図の「コサイン+光源(MIS)」のレンダラーです。
23.10 双方向の手法、メトロポリス、フォトンマッピング
MIS付きのパストレーシングは映画制作の標準ですが、小さな光源からのコースティクス、隙間から入る光、ガラス越しに見る光は難しい儘です。
主な代替手法の考え方を見ます。
双方向パストレーシング
双方向パストレーシング(BDPT。Eric LafortuneとYves Willemsが1993年に、独立にVeachとGuibasが1994年に発表)は、カメラから1本、光源から1本の部分経路を辿り、両者の頂点をシャドウレイで繋ぎます:
同じ完全な経路は、幾つもの方法で作れます:光源側から個、視点側から個の頂点を取ると、頂点の経路は通り(で)に作れます。
図の5頂点()なら6つの手法です:は純粋なパストレーシング(視点側の経路が自分でランプに当たる)、は次イベント推定付きのパストレーシング、は図の接続、と続き、は光源側の経路が自分でカメラに当たる物です(ピンホールカメラでは不可能なので、pdfは0)。
全ての個のpdfに対するMISが其れらを組み合わせます。
MISは正に此の為に考えられたのです。
光源側の頂点を直接カメラに繋ぐの手法がライトトレーシングで、直接見えるコースティクス(LS+DE)を簡単に描けます。
代償は複雑さと、1サンプルあたりの仕事の多さです。
メトロポリス光輸送
BDPTにとっても稀な経路があります。
半開きのドアから入る光の様な物です。
メトロポリス光輸送(MLT。VeachとGuibas、1997年)はメトロポリス・ヘイスティングス法(1953年、1970年)を使います:光を運ぶ経路が一度見つかったら、其の近くを探索するのです。
経路のマルコフ連鎖を作ります:今の経路から変異(頂点を動かす、部分経路を取り替える…)を提案し、次の確率で受け入れます。
は経路の明るさ、は一方から他方を提案する確率です。
対称な変異ならは打ち消し合います:明るさ2の経路から0.5の経路へは確率で、3の経路へは必ず移ります。
連鎖は経路を其の明るさに比例して訪れ、画像全体の明るさは別の普通の推定で決めます。
連続するサンプルは相関するので、ノイズは染みの様になり、収束にむらが出ます。
又、連鎖の出発点が最初の内は結果を偏らせます。
主標本空間MLT(Csaba Kelemenら、2002年)は、普通のパストレーサーを動かす乱数の方を変異させる事で、此の手法を大幅に簡単にしました。
プログレッシブフォトンマッピング
第12章のフォトンマッピングは、フォトンの密度から放射輝度を推定します。
其れは半径の範囲でぼけるのでバイアスがあり、フォトン数が無限大に、同時にが0に向かう時にだけ一致性を持ちます。
1つのフォトンマップを記憶しておく方式では、其れは出来ません。
プログレッシブフォトンマッピング(Toshiya Hachisuka、Shinji Ogaki、Henrik Wann Jensen、2008年)は、フォトンを記憶せずに何回でもフォトンのパスを走らせます。
目からのレイの各交点は半径と数を持ちます。
或るパスで半径の中に新しいフォトンが個見つかったら、其の割合だけを残し、密度が変わらない様に円盤を縮めます:
論文はを使っています。
計算例:、なら、です。
半径はパス毎に縮み、バイアスは0に向かい、パストレーシングを打ち負かすSDSの経路も含めて画像は収束します。
確率的プログレッシブフォトンマッピング(HachisukaとJensen、2009年)は其れを光沢反射や被写界深度に広げ、2012年には2つのグループがフォトンの密度推定とBDPTをMISの下で組み合わせました:vertex connection and merging(VCM。Iliyan Georgievら)とunified path sampling(UPS。Hachisukaら)です。
ボリュームでは媒質の中の散乱の頂点が加わり、23.4節の自由行程のサンプリングを使います(第28章)。
| 手法 | バイアス | 得意 | 苦手 |
|---|---|---|---|
| パストレーシング+NEE+MIS | 不偏 | 殆どのシーン、実装が簡単 | コースティクス、小さな開口部 |
| 双方向パストレーシング | 不偏 | 直接見えるコースティクス、間接光で照らされた部屋 | SDSの経路、1サンプルあたりのコスト |
| メトロポリス光輸送 | 極限で不偏 | 非常に難しい可視性 | 染みの様なノイズ、収束のむら |
| フォトンマッピング(固定のマップ) | バイアスあり、一致性なし | コースティクス、SDS |
ぼけ、メモリ |
| プログレッシブフォトンマッピング | バイアスあり、一致性あり | コースティクス、SDS、メモリが一定 |
拡散光の収束が遅い |
23.11 バイアス・分散・一致性
此処迄使ってきた3つの言葉を、はっきりさせておきます。
- バイアス(偏り):、平均しても残る誤差。バイアスが0の推定量が不偏。
- 分散:の周りのランダムな散らばりで、ノイズとして見える。
- 一致性:仕事(サンプル、フォトン、パス)を無限に増やすと誤差が0に向かう事。分散が有限の不偏推定量には一致性があり、バイアスのある推定量も、バイアスが仕事と共に縮めば一致性を持てる。
実際に目に見えるのは全体の誤差で、平均二乗誤差(MSE)で測ります:
計算例。
同じレンダリング時間で、レンダラーAは不偏で分散0.04、レンダラーBはバイアス0.05で分散0.01とします。
A:MSE = 0.04。
B:MSE = で、約3倍良い。
16倍長くレンダリングすると、AのMSEはに下がりますが、Bはバイアスが残る(Bに一致性が無ければ)のでで、其処からはAが勝ちます。
バイアスのある手法(フォトンマッピング、クランプ、デノイズ)は早く綺麗に見え、不偏な手法は極限で勝ち、誤差をサンプルから見積もれるので信頼し易いのです。
| 技法 | バイアスあり? | 一致性あり? |
|---|---|---|
| パストレーシング、BDPT(ロシアンルーレット付き) | なし | あり |
| 固定の最大経路長 | あり(暗過ぎる) | なし |
| ロシアンルーレット | なし(分散が増える) | あり |
| フォトンマッピング、固定のフォトンマップ | あり(ぼけ) | なし |
| プログレッシブフォトンマッピング | あり | あり |
| サンプル値のクランプ | あり(暗過ぎる) | なし |
| 固定のフィルタによるデノイズ | あり(ぼけ) | なし |
ファイアフライとクランプ
ファイアフライとは、周りよりずっと明るい1つのピクセルです:pdfが小さくが大きいサンプル1つで、典型的には目から見つけたコースティクスです。
サンプルの値が確率99.9%で0.5、0.1%で500のピクセルを考えます:
真の明るさの半分は、稀な経路から来ています。
1サンプルは、分散、標準偏差15.8で、1ピクセルあたり64サンプルでも、ピクセルの値の2倍です。
見える物:此の様なピクセルのは稀なサンプルを捕まえて約を示し、白い点になります。
残りの93.8%は0.5を示し、本来の半分の明るさです。
クランプは全てのサンプルを最大値、例えば10に制限します。
ファイアフライは消えますが、平均はサンプル数に関係なく0.9995ではなくになります。
本格的なレンダラーも其れでもクランプします(多くは間接光だけ。下のデノイズの図も其うしています)。
コースティクスの明るさが欠ける方が、斑点より見る人は気にならないからです。
本当の解決は、其の経路をよく見つける手法です(23.10節)。
23.12 デノイズと適応的サンプリング
映画のフレームは今でも1ピクセルあたり数百から数千サンプルを必要とし、ゲームのフレームに使えるのは1サンプル程度です。
デノイズはノイズのある画像をフィルタで処理して此の差を埋めます。
エッジやテクスチャをぼかさない為に、レンダラーがただで持っている情報を使います。
Gバッファを使う
レンダラーは各ピクセルの最初の交点の法線、位置又は深度、アルベドを知っています。
ディファードレンダラーのGバッファです。
此れらは殆どノイズが無く、エッジがどこにあるかを正確に示します。
クロスバイラテラルフィルタは、第15章のバイラテラルフィルタのエッジの重みを別の画像から取る物で、法線、位置、色が似た近傍だけと平均します。
更に2つの工夫があります:
- アルベドの分離:フィルタの前に色をアルベドで割り、後で掛け戻す。フィルタは照明を均し、テクスチャはくっきりした儘になる。
- 光源を外す:直接見えるランプにはノイズが無く、周りに滲ませてはいけない。
エッジ回避à-trousフィルタ
サンプルが少ないと幅の広いフィルタが要りますが、65 × 65のクロスバイラテラルの窓は1ピクセルあたり4,225タップかかります。
エッジ回避à-trousウェーブレット変換(Holger Dammertz、Daniel Sewtz、Johannes Hanika、Hendrik Lensch、2010年)は、5 × 5のフィルタを、毎回タップの間隔を2倍に広げながら何回も掛けます(「à trous」はフランス語で「穴の開いた」):
- 1次元の重みはB3スプラインので、5 × 5のカーネルは其の積、25タップ。
- パス(0から)はピクセル離れたタップを使うので、5回目のパスは片側ピクセル先に届き、65 × 65の窓になる。
- 各タップの重みには色、法線、位置の差からのエッジ停止関数が掛かり、フィルタはエッジを越えない。
5回のパスで1ピクセルあたり4,225タップではなくタップです。
論文は、残るノイズが小さくなる分、パス毎に色の許容幅を半分にしています。
計算例:1つのタップの重み。
2回目のパスでカーネル座標(+1, 0)、つまり2ピクセル右の近傍のスプラインの重みはです。
SVGFのエッジ停止関数(下)は、此れに法線の重みと輝度の重みを掛けます。
はノイズの局所的な標準偏差です。
なら法線の重みは、の折れ目を越えるとで、実質0です。
で輝度の差が0.1ならで、タップの重みは正規化前でです。
SVGF:時間と分散を加える
SVGF(spatiotemporal variance-guided filtering。Christoph SchiedらNVIDIAとKITのグループ、2017年)は、此れを1ピクセルあたり1サンプルのリアルタイムのデノイザーにしました:
- 時間方向の蓄積:前のフレームの結果をモーションベクトルで再投影して混ぜる。、。此の移動平均はノイズの分散をに減らし、9フレームの平均と同じ位。遮蔽が外れた所では履歴をリセットする。
- 分散の推定:時間方向に蓄積したモーメントから、ピクセル毎の輝度の分散を求める(履歴が短い所では空間的に推定)。
- à-trousフィルタ:法線、深度、分散で導かれる輝度の重みを使って5回。ノイズの多い所は強く均し、収束した所には殆ど触れない。分散も色と一緒にフィルタする。
アルベドを分離して、論文は当時のGPUで1920 × 1080に約10 msと報告しています。
1ピクセルあたり8サンプル(間接光は2でクランプ)の箱のシーンを、ガウスぼかしと、此の考え方のà-trousフィルタ(5回のパス。法線、位置、材質によるエッジ停止。空間的な分散の推定で導かれる輝度の重み。アルベドの分離。ランプは除外)で処理した物です。
RMS誤差は表示されるsRGBの値で測りました:
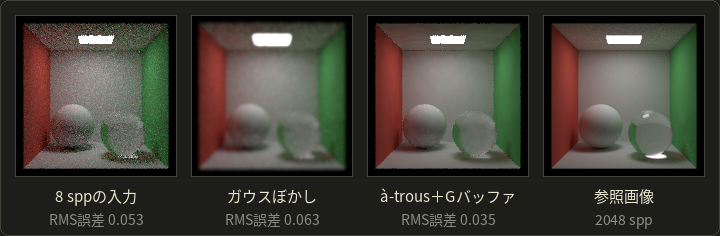
ガウスぼかしは入力より悪くなります:全ての所でノイズをぼけと交換し、ランプを滲ませるのです。
エッジを考えるフィルタは誤差を3分の1減らし、形をくっきり保ちます。
しかしガラス球の下のコースティクスは消えています。
クランプされ、平均されて無くなったのです:デノイズのバイアスが目に見える形です。
ニューラルデノイザー
2017年以降、最良のデノイザーは、ノイズのあるレンダリングと収束したレンダリングの組で学習し、Gバッファも入力に取るニューラルネットワークです。
例えばChakravarty Alla Chaitanyaらの再帰型オートエンコーダーや、Steve Bako、Thijs Vogelsらのカーネル予測ネットワーク(どちらも2017年)です。
執筆時点では、IntelのOpen Image DenoiseとNVIDIAのOptiXのデノイザーがレンダラーで広く使われています。
ゲームではNVIDIAのDLSS Ray Reconstruction(2023年)が手作業で調整したデノイザーを置き換え、デノイズとアップスケーリングを一緒に行います。
ニューラルレンダリングは第29章の話題です。
適応的サンプリング
照らされた壁は数サンプルで収束しますが、コースティクスの光沢のある映り込みには何千サンプルも要ります。
適応的サンプリングは各ピクセルの平均と標本標準偏差を見積もり、相対誤差が目標を下回る迄サンプリングを続けます:
計算例。
目標。
、のノイズの多いピクセルにはサンプル、の落ち着いたピクセルにはサンプルで足ります。
分散の推定自体にもノイズがあり(稀なコースティクスに未だ出会っていないピクセルは収束した様に見えるので、最小のサンプル数を決めておきます)、ピクセル自身のサンプルで止める事は僅かなバイアスを生むので、頑健なレンダラーは別のサンプルバッファから誤差を見積もります。
レンダラーは此れを「ノイズの閾値」として見せています。
リアルタイムのレイトレーシングは、更にサンプルをピクセル間やフレーム間で使い回します。
ReSTIRがしている事です(第24章)。
23.13 まとめ
- レンダリングの積分は次元が多い。格子による公式は其処で破綻するが、モンテカルロ法の誤差は次元に依存しない。独立な分散は足し算で、定数倍は2乗で効くからである。
- 推定量は、の所でなら不偏。1サンプルあたりの分散は。
- サンプリング:逆関数法(指数分布の自由行程、コサイン半球)、代わりの手段として棄却法。
- 重点的サンプリング:に似た形のは分散を下げる(正弦なら三角形で14分の1)。が大きい所でが小さ過ぎると無限大にもなる。レンダラーはBSDF(コサイン、のGGXのハーフベクトル)、光源、環境マップをサンプリングする。
- 層化(ジッター)サンプリングと準モンテカルロ法(ハルトン列1960年、ソボル列1967年)はサンプルを均等に広げる。乱択QMCは不偏性を保つ。
- 光源サンプリング(NEE):。点光源に届く唯一の方法。光源が多ければ確率で1つを選び、其の確率で割る。
- MISは和が1になる重みで手法を組み合わせる:バランスヒューリスティック、2乗を使うパワーヒューリスティック。決して破綻せず、最良の手法に近い。
- 経路積分:ピクセル = 経路についてのの積分。パストレーサーは跳ね返る毎にスループットにを掛ける。ロシアンルーレットは不偏だが分散を加え、固定の深さの上限にはバイアスがある。鏡とガラスはデルタBSDFで、其処では光源サンプリングをしない。
- BDPTは視点側と光源側の部分経路を繋ぐ(頂点に通りの手法、MISで組み合わせる)。MLTは明るい経路を変異させる。プログレッシブフォトンマッピングは半径を縮め、バイアスはあるが一致性がある。
- MSE = 分散 + バイアス²。クランプはバイアスと引き換えにファイアフライを消す。デノイザーはGバッファを使う(クロスバイラテラル、à-trous、SVGF、ニューラルネットワーク)。適応的サンプリングは見積もった誤差が大きい所にサンプルを使う。
23.14 用語
| English | 日本語 |
|---|---|
| Monte Carlo integration | モンテカルロ積分(モンテカルロ法) |
| curse of dimensionality | 次元の呪い |
| random variable | 確率変数 |
| expected value | 期待値 |
| variance | 分散 |
| standard deviation | 標準偏差 |
| probability density function (pdf) | 確率密度関数(pdf) |
| cumulative distribution function (CDF) | 累積分布関数(CDF) |
| estimator | 推定量 |
| unbiased | 不偏 |
| inversion method | 逆関数法 |
| rejection sampling | 棄却法 |
| cosine-weighted hemisphere sampling | コサイン重み付き半球サンプリング |
| importance sampling | 重点的サンプリング |
| BSDF sampling | BSDFサンプリング |
| stratified sampling, jittered sampling | 層化サンプリング、ジッターサンプリング |
| quasi-Monte Carlo | 準モンテカルロ法 |
| low-discrepancy sequence | 低食い違い量列 |
| discrepancy | 食い違い量 |
| radical inverse | ラディカルインバース |
| van der Corput / Halton / Sobol sequence | ファン・デル・コルプット列/ハルトン列/ソボル列 |
| blue noise | ブルーノイズ |
| light sampling | 光源サンプリング |
| next event estimation (NEE) | 次イベント推定(NEE) |
| multiple importance sampling (MIS) | 多重重点的サンプリング(MIS) |
| balance heuristic / power heuristic | バランスヒューリスティック/パワーヒューリスティック |
| path integral formulation | 経路積分による定式化 |
| geometry term | 幾何項 |
| throughput | スループット |
| Russian roulette | ロシアンルーレット |
| efficiency | 効率 |
| delta distribution | デルタ分布 |
| bidirectional path tracing | 双方向パストレーシング |
| light tracing | ライトトレーシング |
| Metropolis light transport | メトロポリス光輸送(MLT) |
| Markov chain / mutation | マルコフ連鎖/変異 |
| progressive photon mapping | プログレッシブフォトンマッピング |
| bias | バイアス(偏り) |
| consistency | 一致性 |
| mean squared error (MSE) | 平均二乗誤差(MSE) |
| firefly | ファイアフライ |
| clamping | クランプ |
| denoising | デノイズ |
| G-buffer | Gバッファ |
| cross-bilateral filter | クロスバイラテラルフィルタ |
| albedo demodulation | アルベドの分離 |
| edge-avoiding à-trous wavelet transform | エッジ回避à-trousウェーブレット変換 |
| edge-stopping function | エッジ停止関数 |
| temporal accumulation | 時間方向の蓄積 |
| adaptive sampling | 適応的サンプリング |
23.15 課題
- ★ 一様なサンプルでを推定し、次に同じから逆関数法でpdf に従うサンプルを作って推定して下さい。両方の推定量の1サンプルあたりの正確な分散も求めて下さい。(確認:正確な積分は、2つ目の推定量の分散は。)
- ★ 基数2と3でハルトン列の点11を、又ファン・デル・コルプット列の点9から12を求めて下さい。2進の最初の12個の値を数直線に記し、幅1/8の8つの区間の内、8点の後と12点の後に其々幾つの区間に点があるか数えて下さい。
- ★★ 、のGGXサンプリングで、、、、そして法線の真上から見る時のと反射方向の角度を求めて下さい。でも計算して比べて下さい。
- ★★ 光源のサンプルがで、同じ方向のBSDFのpdfがです。BSDFのサンプルはで、の所で光源に当たります。全てのバランスとパワーの重みを求め、各点で和が1になる事を確かめて下さい。次に、スループット0.2の経路がのロシアンルーレットに出会います。取り得るスループットを挙げ、期待値が変わらない事を示し、残りの寄与について増える分散を求めて下さい。
- ★★★ 点光源がガラス球を通して艶消しのテーブルを照らし、カメラは其のコースティクスを鏡の中にしか見ません。経路をヘックバートの表記で書き、NEE付きのパストレーシング、ライトトレーシング、BDPT、プログレッシブフォトンマッピングのどれが其れを描けるか、其の理由と共に説明して下さい。
選択問題
問1 ★ 次のうち、モンテカルロ推定量について正しい物はどれか。
| あ | 誤差はに比例して減る。 |
| い | となる所で常になら、不偏である。 |
| う | 重点的サンプリングで不偏性が保たれるのは、がに丁度比例する時だけである。 |
| え | サンプル数を2倍にすると、標準偏差は半分になる。 |
| お | 層化サンプリングは、独立な一様サンプルに比べて必ず分散を大きくする。 |
問2 ★★ 次のうち、多重重点的サンプリングについて正しい物はどれか。
| あ | バランスヒューリスティックで2つの手法から1サンプルずつ取る時、点xでの手法iの重みはであり、2つの重みの和は1になる。 |
| い | 重みは、其々が0と1の間にありさえすれば、自由に選んで良い。 |
| う | パワーヒューリスティックは、バランスヒューリスティックよりもpdfの小さい手法に大きな重みを与える。 |
| え | 完全な鏡では、光源サンプリングもBSDFサンプリングも反射方向を生成出来るので、其処でMISが両者を組み合わせる。 |
| お | MISは、同じサンプル数の最良の単独の手法よりも、常に分散が小さい。 |
問3 ★★ 次のうち、バイアスと一致性について正しい物はどれか。
| あ | サンプル値のクランプは、ピクセルの期待値を変えずにファイアフライを取り除く。 |
| い | ロシアンルーレットは、光源に届く前に止まる経路がある為、バイアスを生む。 |
| う | 固定のフォトンマップを使うフォトンマッピングは、1ピクセルあたりの目からのレイを無限に増やせば正確な解に収束する。 |
| え | 同じレンダリング時間なら、バイアスのある手法の平均二乗誤差は、常に不偏な手法より大きい。 |
| お | プログレッシブフォトンマッピングはバイアスを持つが、フォトンのパスを増やすと誤差が0に向かう。つまり一致性がある。 |
23.16 実践課題
1つの点の直接光を、幾つかのサンプリング方法で手計算します。
方眼紙、定規、分度器、電卓を用意して下さい。
フラットランド、つまり2次元の断面で考えます:方向は法線から測った角度(右が正)で、「放射照度」はから迄のです。
立体角の代わりに、ラジアンのを使います。
点は床の原点(法線は上向き)、ランプは高さでから迄(長さ)の水平な線分で、下を向き、放射輝度はです。
どの手法にも乱数を使います。
- 作図。 床、点、法線、ランプを描き(1単位 = 2マス)、ランプの両端へのレイを引いて、法線との角度を測って下さい。
- 正確な答え。 ランプはからを覆うのでです。計算して下さい。
- 一様な角度。 でサンプリングします(pdf )。各レイを描き、当たれば、外れれば0です。4つの項を平均して下さい。
- コサインサンプリング。 フラットランドのコサインのpdf から逆関数法でを導き、当たったサンプルは全て丁度を返す事を示し、4つの項を平均して下さい。
- 光源サンプリング。 ランプ上のを選び、とを求めます。フラットランドではなので、各項はです。レイを描き、項を平均して下さい。
- 比較。 各手法の標本分散と、平均の誤差を求めて下さい。此処ではどれが一番良く、其のpdfの形でどう説明出来ますか?
- MIS。 各光源サンプルについて、、を求め、当たったコサインサンプルについては当たった点、、を求めて下さい。光源サンプルとコサインサンプルを組にすると、バランスヒューリスティックでは各項はです。4つの組の推定値を平均して下さい。
- 層化とQMC。 与えた数はの4分の1毎に1つずつあり、層化された組です。ファン・デル・コルプット列の値で手順5をやり直し、4点の後と8点の後で平均して、誤差を比べて下さい。
自分で確かめる方法:正確な値はで、4サンプルでは平均は其の周りに散らばります(光源サンプリングは数%以内、一様とコサインは大きく外れる事もある)。
光源サンプリングの項はランプに沿って単調に減り、との間に入ります。
1つの方向の2つのMISの重みは足して1になり、此のランプの上では全てです(、)。
終わった後の参考に、1サンプルあたりの正確な分散は1.519(一様)、0.914(コサイン)、0.0445(光源)です。
コメント(0)
まだコメントはありません。
ログインするとコメント出来ます。