20. アンチエイリアシングと透明表現
第1部では、2つの問題が半分だけ解決されたまま残っていました。
第2章では、シーンを1ピクセルに1回標本化するとジャギー、モアレ、ちらつく輪郭が生まれる事を見ました。
第6章では、GPUが其れに対してMSAAと言う安価な工夫を使う事に触れました。
第10章では、アルファブレンディングが描画順に依存し、半透明の物体の並べ替えは物体同士が交わった途端に破綻する事を見ました。
どちらも、詳しい話は第2部に先送りしていました。
此の章で其の約束を果たします。
前半はリアルタイムのアンチエイリアシングです。再構成フィルタ、スーパーサンプリング、MSAAの詳細、ポストプロセス手法のMLAA・FXAA・SMAA、時間方向アンチエイリアシング(TAA)、そして鏡面反射のエイリアシングを扱います。
後半はリアルタイムの透明表現です。並べ替え、アンダー演算、デプスピーリング、ピクセルごとの連結リスト(第10章のAバッファのGPU版)、重み付きブレンドによる順序非依存の半透明を扱います。
何れも検定のシラバスの範囲を超えますが、2つのシラバス項目を掘り下げる物です。
アンチエイリアシング(第2章と第6章)と、アルファブレンディングによる半透明(第10章)です。
数学は軽めで、重み付き平均、over演算子、そして投影行列が1つ出て来るだけです。
ラスタライザー其の物(エッジ関数、トップレフトルール、2×2のクアッド)は第19章で扱います。
此処では、其れが何処で標本化するかだけが問題です。
20.1 リアルタイムレンダリングのエイリアシング
2.6節の規則を思い出して下さい。
1ピクセルに1サンプルなら、画像が持てるのは最大で2ピクセルに1周期までで、其れより細かい物は粗い模様に化けて戻って来ます。
リアルタイムのフレームは、此の規則を4つの違う場所で破り、其々に別の対策があります:
- 幾何学的エイリアシング:三角形の辺は急な段差なので、シルエットや交差線が階段になり、細い三角形(電線、フェンス)はサンプルの間に落ちてちらつきます。
- シェーディングのエイリアシング:フラグメントシェーダー自身が、平らな三角形の内側でさえ、ピクセルより細かい模様を作ります。代表例は鏡面反射のエイリアシングで、凸凹した光沢面のハイライトがキラキラと瞬きます(20.7節)。
- テクスチャのエイリアシング:縮小されたテクスチャです。ミップマップと異方性フィルタリング(第11章の11.7節)が前もって殆ど解決しています。
- 時間方向のエイリアシング:カメラが1ピクセル未満だけ動くと、階段の形がフレームごとに変わり、輪郭が這う様に動き、細部がちらつきます。
2.7節の2つの正攻法は今も有効です。
プリフィルタリング(ミップマップがテクスチャに対して行う様に)か、サンプルを増やして後でフィルタで1つにまとめるかです。
任意のシェーダーをピクセル全体で積分するのは難しいので、此の章の殆どはサンプルを増やす為の工夫です。
1フレームの中で1ピクセルあたりに増やす(SSAA、MSAA)か、複数のフレームにまたがって増やす(TAA)かです。
ポストプロセス手法は例外で、完成した画像から足りないサンプルを推測します。
20.2 再構成フィルタ
1ピクセルに複数のサンプルを取ったら、フィルタで其れを1つの値にまとめます。
Alvy Ray Smithの有名な1995年のメモ「A Pixel Is Not a Little Square」は、ピクセルは小さな正方形ではなく点のサンプルだ、と指摘しています。
其の考え方では、ピクセルの値を求める事は、サンプルから連続した画像を再構成し、其れをピクセル中心で評価する事です。
フィルタは、各サンプルを中心からの距離(ピクセル単位)で重み付けします:
重みの合計で割るので、一様な領域は其の色のまま保たれます。
よく使うフィルタは次の4つです(2次元ではxとyの両方向に適用します):
- ボックスフィルタ:なら、其れ以外は0。ピクセル内のサンプルを等しく扱い、ハードウェアのMSAAのリゾルブが行うのも此れです。切れ目が急なので、エイリアシングが少し漏れます。
- テントフィルタ:。中心に近いサンプルほど重く、隣のピクセルのサンプルも少しだけ数えます。
- ガウシアンフィルタ:。なら約1.5ピクセルまで届きます。エイリアシングにはとても強く、少しぼやけます。
- ミッチェル・ネトラバリフィルタ(MitchellとNetravali、1988年):半径2の3次式で、パラメータ、を持ちます。推奨値のはぼけとリンギングの折衷です。1〜2ピクセルの所に小さな負のローブがあり、輪郭を少しだけシャープにします。
ミッチェルフィルタは、で、では次の式です:
なら、、、、で、カーネル全体の積分は丁度1です。
図では各フィルタを面積1に揃えて描いているので、ガウシアンの山は約0.8になっています。式は重みの合計で割るので、定数倍は結果に影響しません。
計算例:ボックスとテント。
1次元の列で、各ピクセル中心からの位置に2つずつサンプルがあるとします。
ピクセル0の中心は0、ピクセル1の中心は1なので、サンプルはにあります。
に輪郭があると、サンプルの値はです(輪郭の左が白、右が黒)。
ボックスでは、ピクセル0はとを平均して、ピクセル1はとを平均して0です。
1ピクセルに2サンプルあっても、急な段差のままです。
テントでは、ピクセル0は距離0.75、0.25、0.25、0.75のサンプルを重み0.25、0.75、0.75、0.25(合計2)で数えます:
輪郭の位置がピクセルの値に現れる様になり、輪郭がゆっくり動くと値も跳ばずに滑らかに変わります。
代償は少しのぼけです。
オフラインのレンダラーではフィルタを選べますが、リアルタイムのエンジンは殆どハードウェアのリゾルブのボックスフィルタを使うか、TAA(20.6節)に時間方向のフィルタリングを任せます。
20.3 スーパーサンプリング(SSAA)
大きく描いてから縮める
2.7節のスーパーサンプリング(SSAA)は、1ピクセルあたり個のサンプルの其々について、パイプライン全体(カバレッジ、深度テスト、フラグメントシェーダー)を実行し、フィルタで1つにまとめます。
幾何学的、シェーディング、テクスチャのエイリアシングを一度に解決しますが、ピクセルの仕事は丁度倍になります。
計算例。 1920×1080はピクセルです。
4× SSAAならサンプルで、其々がシェーダーの実行、色、深度を持ちます。
色4バイト(RGBA8)と深度・ステンシル4バイトならバイト、約63.3 MiBで、アンチエイリアシング無しの15.8 MiBの4倍です。
ピクセルの仕事が10 msなら約40 msになり、60 fpsには届きません。
SSAAはオフライン、スクリーンショット、又は新しいハードウェアで動かす古いゲームで使われます(1080pの画面の為に4Kで描くのもSSAAです)。
格子配置と回転格子
サンプルの数と同じ位、其の位置が大事です。
2×2の格子配置は、あたし達が一番気付き易い、ほぼ垂直とほぼ水平の輪郭に弱いのです。
計算例。 の垂直な輪郭は、ピクセルの70%を覆います。
格子配置のサンプルはとにしか無いので、輪郭が横に動いてもの3段階しか出せず、此処ではです。
次の節の4×標準配置の様な回転格子(RGSS)はを持つので5段階を踏み、此処ではと、0.7にずっと近くなります。
一般に、行も列も全て違う個のサンプル(チェス盤で互いに取り合わない個のルークの様な配置)は、垂直と水平の輪郭に対して段階を与えますが、の格子配置は段階しか与えません。
其の為、GPUのサンプル配置は格子ではなく、散らばった様に見えます。
20.4 マルチサンプルアンチエイリアシング(MSAA)
考え方
普通のフレームでは、エイリアシングの殆どは三角形の辺から来ます。
一方、三角形の内側のシェーディングはゆっくり変わります(テクスチャはミップマップでプリフィルタされています)。
マルチサンプルアンチエイリアシング(MSAA)は此の事を利用します:
- カバレッジと深度は、1ピクセルあたり個のサンプル点で判定し、各サンプルは自分の深度、ステンシル、色を持ちます。
- フラグメントシェーダーはピクセルごと・三角形ごとに1回だけ実行し、其の色を、三角形が覆い深度テストに通った全てのサンプルに書き込みます。
- 最後にリゾルブが、個のサンプルの色を平均して最終的なピクセルにします。
三角形の内側のピクセルは、1回のシェーダー実行で個の同じサンプルを得ます。
2つの三角形の境目のピクセルではシェーダーが2回走り、リゾルブがカバレッジに応じて色を混ぜます。
深度がサンプルごとにあるので、三角形同士が貫通する交差線もアンチエイリアスされます。
第10章で約束した事です。
サンプルパターン
VulkanとDirect3Dは、2、4、8、16サンプルの標準サンプル位置を定義していて、殆ど全てのデスクトップGPUが対応しています(Vulkanでは制限値standardSampleLocationsで分かります)。
原点をピクセルの左上の角、yを下向きにしたピクセル座標で、4×の配置はの倍数の上の回転格子です:
| サンプル | x | y |
|---|---|---|
| 0 | 0.375 | 0.125 |
| 1 | 0.875 | 0.375 |
| 2 | 0.125 | 0.625 |
| 3 | 0.625 | 0.875 |
計算例:1ピクセルと2つの三角形
図の輪郭は直線で、三角形Bはの部分です。
- カバレッジ。 はサンプル0で、サンプル1で、サンプル2で、サンプル3でです。0.35を超えるのはサンプル1だけなので、Bがサンプル1を、Aがサンプル0、2、3を覆います。ビットマスク(ビットがサンプル)ではAが、Bがです。
- シェーディング。 フラグメントシェーダーは2回走ります。Aはオレンジ、Bは青になったとします。
- 書き込み。 サンプル0、2、3にオレンジ、サンプル1に青が入ります。
- リゾルブ。 です。
Bの本当の取り分は、、、の三角形で、面積はです。
従って正確な色はです。
MSAAの見積もり0.25は0.04ずれていますが、中心の1サンプルなら0と答え、ピクセルは完全にオレンジになっていました。
シェーダーは何処で走るか:セントロイドサンプリング
Bのシェーダーは1回走りましたが、場所はピクセル中心で、此れはBの外です。
其の為、属性は外挿されています。
アトラスの1区画の端を越えて外挿されたテクスチャ座標は、隣の画像を読んでしまい、輪郭に色の付いた継ぎ目を残す事があります。
セントロイドサンプリングは、中心が覆われていない時、覆われたサンプル(又は覆われたサンプルの重心)で属性を評価します。
GLSLではcentroid修飾子(centroid in vec2 uv;)、SlangとHLSLではcentroid補間修飾子です。
但し、隣のピクセル同士が違う位置で評価する事があるので、微分(dFdx、ddx)の精度が落ちます。
メモリとコストの計算
MSAAが節約するのはシェーディングで、メモリではありません。
1920×1080の4× MSAAは、4× SSAAと同じ63.3 MiBのサンプルバッファに加え、1サンプルのリゾルブ先バイト(7.9 MiB)が要ります。
ピクセルの8%が2つの三角形の境目にあるなら、シェーダーは約回走り、SSAAの回の約3.7分の1です。
GPUはMSAAのバッファを圧縮もします(全サンプルが同じピクセルは、1つの値と印だけで済ませます)。
此れはメモリ帯域を節約します。
タイルベースのモバイルGPU(第17章の17.4節)はサンプルをチップ上のタイルメモリに置き、リゾルブ済みのピクセルだけを書き出すので、4× MSAAは帯域の面では殆ど只です。
隠れたコストが1つあります。
シェーダーは2×2ピクセルのクアッド単位で走り(第19章)、小さな三角形にたくさん触られたピクセルは三角形ごとに1回シェーダーを走らせます。
其の為、細かいメッシュではMSAAは8%の見積もりよりずっと高く付きます。
MSAAが直さない物
ピクセルごとに1回しかシェーディングしないので、MSAAはシェーディングのエイリアシングには何もしません。
図は、縞の間隔が1.45ピクセル、つまりナイキストの限界の2ピクセルより細かい三角形です。
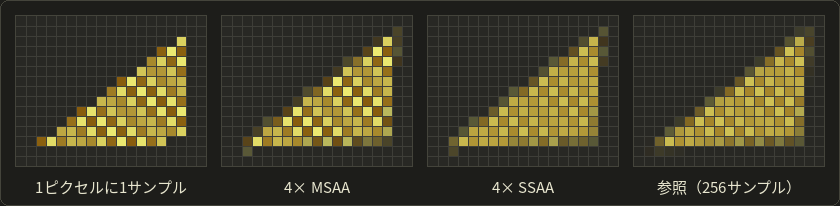
4× MSAAは輪郭を滑らかにしますが、内側には1サンプルと同じ偽の模様が残り、4× SSAAは其の殆どを消します。
其れが問題になる時は、MSAAをサンプルシェーディングに切り替えられます。
VulkanではsampleShadingEnableとminSampleShading、OpenGLではglMinSampleShadingを使うか、シェーダーでgl_SampleID(GLSL)やSV_SampleIndex(Slang、HLSL)を読むだけで済みます。
MSAAのハードウェアの上のSSAAで、コストもSSAAと同じです。
もう1つの穴はアルファテストされた形状です。
葉やフェンスは、テクスチャを貼った四角形として描かれ、シェーダーはアルファが0.5未満のフラグメントを捨てます。
捨てるかどうかはピクセルごとに1回決まるので、8× MSAAでも葉の輪郭はエイリアシングしたままです。
アルファトゥカバレッジ
アルファトゥカバレッジは、シェーダーのアルファをカバレッジマスクに変換します。
アルファは、個のサンプルの内、約個を覆います。
計算例。 4× MSAAでならなので2サンプルが覆われ、リゾルブ後のピクセルは葉が半分、背景が半分です。
ならサンプルで、完全に不透明です。
フィルタされたアルファが1〜2ピクセルで1から0へ下がる葉の輪郭では、カバレッジも滑らかに下がるので、輪郭がアンチエイリアスされます。
しかもサンプルは普通の不透明な面と同じく深度を書くので、並べ替えは要りません。
4サンプルでは5段階しか無い(ハードウェアは段差を隠す為にマスクをディザリングする事が多い)ので、切り抜きの輪郭には向きますが、本物のガラスには向きません。
VulkanではalphaToCoverageEnable、OpenGLではglEnable(GL_SAMPLE_ALPHA_TO_COVERAGE)で有効にします。
CSAAとEQAA
カバレッジは1サンプル1ビットで済みますが、色と深度はずっと高く付きます。
其の為、NVIDIAのCSAA(GeForce 8800、2006年)とAMDのEQAA(Radeon HD 6900、2010年)は、色よりも多くのカバレッジサンプルを持ちました。
例えばカバレッジ16ビットに対して色は4つで、16×に近い段階を4×に近いコストで得ます。
此れらはAPIの機能ではなくドライバのオプションでした。
残った考え方は、「輪郭が何処にあるか」と「何色か」を分ける事です。
MSAAとディファードシェーディング
ディファードシェーディング(第17章の17.4節のディファードレンダリング)は、MSAAの取引を壊します。
Gバッファはサンプルを保たなければならず(境目のピクセルは2つの材質を持ちます)、ライティングのパスは境目のピクセルのサンプルを1つずつ照らさなければなりません。
ライティングの前に法線や材質を平均するのは間違いだからです。
計算例。 第17章の1ピクセル20バイトのGバッファ(1920×1080で41.5 MB)は、4× MSAAではバイト、約165.9 MBになり、毎フレーム書いて読みます。
しかもライティングのパスは、まず境目のピクセルを見つけて、其処だけサンプルごとに照らす必要があります。
実際に此れを製品に載せたエンジンもありますが、此のメモリと複雑さが、ディファードのエンジンがポストプロセスや時間方向の手法へ移った大きな理由です。
フォワードレンダラー(VRでよく使われます)なら、MSAAは安いままです。
実際の使い方
VulkanではVK_SAMPLE_COUNT_4_BITの様なサンプル数で画像を作り、パイプラインにrasterizationSamplesを設定し、リゾルブアタッチメントかvkCmdResolveImageでリゾルブします。
OpenGLではマルチサンプルのフレームバッファに描き、glBlitFramebufferでリゾルブします。
此れはOpenGLシリーズの第20章で自分で行います。
ハードウェアのリゾルブは保存された値を其のまま平均するので、線型のHDRの値では明るいハイライトが平均を支配します。
其の為、丁寧なエンジンはサンプルごとにトーンマッピングするか、自前のリゾルブシェーダーを書きます。
20.5 ポストプロセスアンチエイリアシング
考え方
ポストプロセスアンチエイリアシングは、1ピクセル1サンプルの完成した画像に対して働きます。
階段を見つけ、其の裏にある滑らかな輪郭を推測し、境目の各ピクセルを、其の輪郭が覆ったはずの割合で隣のピクセルと混ぜます。
コストはフルスクリーンのパス1〜3回で、ディファードシェーディングでも使え、追加のサンプルは要りません。
2.7節で注意した通り、1ピクセル1サンプルで既に失われた物は取り戻せません。
ピクセルより細い電線は途切れたままです。
MLAA
モルフォロジカルアンチエイリアシング(MLAA、Alexander Reshetov、Intel、2009年)が此の系統の始まりで、元々はCPUで動いていました:
- 輪郭を見つける:色の差が閾値を超える隣同士のピクセルの間に印を付けます。
- 形を見つける:輪郭を辿り、階段の各段を、両端の曲がり方で分類します(論文のL、Z、Uの形)。
- 混ぜる:段の中点を通る直線として輪郭を再構成し、各ピクセルを、其の直線が切り取る面積の分だけ、輪郭の反対側のピクセルと混ぜます。
計算例。 図形の境界は4ピクセルごとに1ピクセル上がります。
MLAAは垂直な段の中点とを結ぶので、最初の段での輪郭はです。
一方、エイリアシングした境界は高さ1にあります。
各ピクセルの重みは、其の幅の上で2本の線に挟まれた面積です:
- ピクセル0:。直線は境界より下なので、此の図形のピクセルは背景の色を37.5%受け取ります。
- ピクセル1:。
- ピクセル2:此処からは直線が境界より上なので、上の背景のピクセルが図形の色をだけ受け取ります。
- ピクセル3:。
本当の輪郭が本当に直線だったなら、此れらはエリアサンプリング(第2章のプリフィルタ)が出す覆い具合と完全に一致します。
MLAAは、1サンプルの画像からアンチエイリアスされた輪郭を復元したのです。
本当の輪郭が曲線や細い物だった時は推測が外れ、其処からアーティファクトが生まれます。
FXAA
FXAA(fast approximate anti-aliasing、Timothy Lottes、NVIDIA。ホワイトペーパーの日付は2009年で、広く使われたFXAA 3と3.11は2011年に公開されました)は、安価な1回のピクセルシェーダーのパスで、ルーマだけを見ます。
ルーマは例えば第3章の3.6節ので、緑のチャンネルだけで代用する事も出来ます:
- ピクセルと上下左右の4つの隣の局所コントラスト(ルーマの最大から最小を引いた物)を求めます。閾値未満ならピクセルには何もしません。殆どのピクセルは此処で終わります。
- 輪郭が水平か垂直かを決め、両方向に輪郭を辿って、階段の此の段が何処で終わるかを探します。
- 段の上でのピクセルの位置から、輪郭を横切る方向のサブピクセルのずれを求め、其の位置で画像をバイリニアフィルタリングで読みます。1回のテクスチャ読み込みで、ピクセルと隣を混ぜられます。
判定の計算例。 中心0.8、左0.8、上0.8、右0.1、下0.1なら、コントラストは典型的な閾値の約0.1を大きく超えるので、此のピクセルは処理されます。
ルーマが0.62〜0.65の空はコントラストが0.03なので、飛ばされます。
FXAAはどんなレンダラーにも組み込めるので急速に広まりましたが、細かいテクスチャや文字もぼかすので、ユーザーインターフェースを描く前に実行する必要があります。
SMAA
SMAA(enhanced subpixel morphological anti-aliasing、Jorge Jimenez、Jose Echevarria、Tiago Sousa、Diego Gutierrez、Eurographics 2012)は、MLAAをGPU向けに3つのパスで改良した物です:
- ルーマ、色又は深度による輪郭検出。局所コントラスト適応付きで、周りの輪郭に比べて強い輪郭だけを残すので、テクスチャの細部を守ります。
- ブレンドの重みの計算。各輪郭に沿って段の両端を探し、両端までの距離と端の形を添え字にして、前もって計算したエリアテクスチャから重みを引きます。斜めの輪郭は別に扱います。
- 其の重みによる近傍ブレンド。
MLAAより角を鋭く保ち、FXAAより正確です。
派生版は、サブピクセルの細部の為に2× MSAA(S2x)、時間方向の成分(T2x)、又は両方(4x)を加えます。
3つとも同じ死角を持っています。
サブピクセルの細部は途切れたままで、動きがあると検出される階段が変わるので輪郭はやはりちらつき、テクスチャや文字を輪郭と間違える事があります。
最初の2つは、正にTAAが狙う所です。
20.6 時間方向アンチエイリアシング(TAA)
サンプルを時間に広げる
60 fpsでは、連続するフレームは殆ど同じです。
TAAは1フレームに1ピクセル1つのサンプルを、毎フレームピクセル内の違う位置で取り、各ピクセルを以前の値と混ぜます。
8フレーム後には、止まった画像は1つ分のコストで実質8サンプルを持ちます。
此のアイデアは「amortized supersampling」(Yang、Nehab、Sander、Sitthi-amorn、Lawrence、Hoppe、2009年)として発表され、Brian Karisの「High Quality Temporal Supersampling」(Unreal Engine 4、SIGGRAPH 2014)の様な講演を通じてゲームの標準になりました。
3つの部品から成ります。ジッタ、再投影、履歴の棄却です。
ハルトン列によるジッタ
ジッタは、毎フレーム変わるサブピクセルのずれで投影全体をずらします。
ずれは、数フレームだけでもピクセルを均等に覆うべきです。
乱数のずれは固まりがちですが、低食い違い量列は仕組み上広がります。
よく使うのは、基数2と3のハルトン列です。
其の値はのラディカルインバース(radical inverse)で、を進数で書き、其の桁を小数点の後ろに鏡写しにした物です。
計算例。 を鏡写しにすると、はなので、点6はです。
最初の8点と、ピクセル単位のジッタ:
| i | 2進数のi | 3進数のi | ジッタ(ピクセル) | ||
|---|---|---|---|---|---|
| 1 | 1 | 0.5 | 1 | 0.3333 | (0, −0.1667) |
| 2 | 10 | 0.25 | 2 | 0.6667 | (−0.25, 0.1667) |
| 3 | 11 | 0.75 | 10 | 0.1111 | (0.25, −0.3889) |
| 4 | 100 | 0.125 | 11 | 0.4444 | (−0.375, −0.0556) |
| 5 | 101 | 0.625 | 12 | 0.7778 | (0.125, 0.2778) |
| 6 | 110 | 0.375 | 20 | 0.2222 | (−0.125, −0.2778) |
| 7 | 111 | 0.875 | 21 | 0.5556 | (0.375, 0.0556) |
| 8 | 1000 | 0.0625 | 22 | 0.8889 | (−0.4375, 0.3889) |
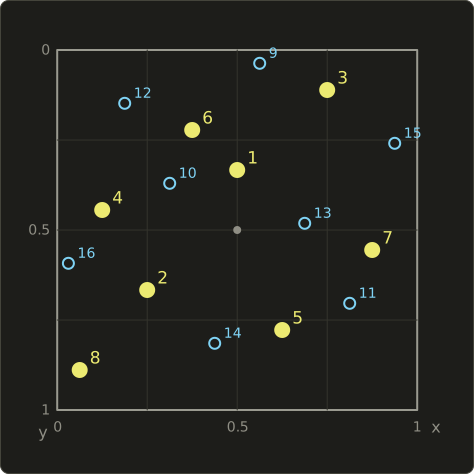
新しい点は、残っている大きな隙間に落ち、9〜16の点は最初の8点の間の穴を埋めます。
エンジンは其の内8個か16個を繰り返し使い、ピクセルの角になる添え字0は飛ばします。
低食い違い量列は、第23章のモンテカルロ積分で又出て来ます。
投影をずらす。 幅ピクセルの画面でのピクセルのずれは、2単位の幅を持つNDCではです。
此れを透視除算の後のに足すには、除算の前のにを足せば良いのです。
此れは正に、平行移動行列が同次座標のベクトルに行う事です(線型代数シリーズ第9章):
透視投影でも平行投影でも同じ様に使えます。
線型代数シリーズのヘッダーを使い、点を投影して確かめます:
#include <cstdio>
#include <numbers>
#include "linalg.hh"

// Radical inverse: the i-th point of the Halton sequence in base b.
float halton(int i, int b) {
  float f = 1.0f, r = 0.0f;
  while (i > 0) {
    f /= b;
    r += f * (i % b);
    i /= b;
  }
  return r;
}

// Sub-pixel jitter for frame n (cycle of 8), in pixels, in [-0.5, 0.5).
Vec2 jitter(int frame) {
  int i = frame % 8 + 1;  // skip index 0, which is (0, 0)
  return {halton(i, 2) - 0.5f, halton(i, 3) - 0.5f};
}

// Shift the whole image by j pixels: translate clip space by 2j / size in NDC.
Mat4 jitteredProjection(const Mat4 &proj, Vec2 j, int width, int height) {
  return translate({2.0f * j.x / width, 2.0f * j.y / height, 0.0f}) * proj;
}

// Window coordinates of a view-space point (pixel units, OpenGL convention).
Vec2 toPixels(const Mat4 &proj, Vec3 p, int width, int height) {
  Vec4 c = proj * Vec4{p.x, p.y, p.z, 1.0f};
  return {(c.x / c.w * 0.5f + 0.5f) * width, (c.y / c.w * 0.5f + 0.5f) * height};
}

int main() {
  const int W = 1920, H = 1080;
  Mat4 proj = perspectiveGl(std::numbers::pi_v<float> / 3.0f, float(W) / H, 0.1f, 100.0f);
  Vec3 p{0.0f, 0.0f, -5.0f};  // lands on the image center
  Vec2 base = toPixels(proj, p, W, H);
  printf("unjittered: (%.3f, %.3f)\n", base.x, base.y);
  for (int frame = 0; frame < 8; ++frame) {
    Vec2 j = jitter(frame);
    Vec2 q = toPixels(jitteredProjection(proj, j, W, H), p, W, H);
    printf("frame %d: jitter (%+.3f, %+.3f)  moved by (%+.3f, %+.3f)\n",
           frame, j.x, j.y, q.x - base.x, q.y - base.y);
  }
}
unjittered: (960.000, 540.000)
frame 0: jitter (+0.000, -0.167)  moved by (+0.000, -0.167)
frame 1: jitter (-0.250, +0.167)  moved by (-0.250, +0.167)
frame 2: jitter (+0.250, -0.389)  moved by (+0.250, -0.389)
frame 3: jitter (-0.375, -0.056)  moved by (-0.375, -0.056)
frame 4: jitter (+0.125, +0.278)  moved by (+0.125, +0.278)
frame 5: jitter (-0.125, -0.278)  moved by (-0.125, -0.278)
frame 6: jitter (+0.375, +0.056)  moved by (+0.375, +0.056)
frame 7: jitter (-0.438, +0.389)  moved by (-0.438, +0.389)
投影された点は丁度ジッタの分だけ動き、はNDC全体をずらすので、他の全ての点も同じだけ動きます。
perspectiveVkでも其のまま動きます。
VulkanではNDCのyもフレームバッファのyも下向きだからです。
蓄積:指数移動平均
TAAは古いフレームを8枚保存する代わりに、履歴の画像を1枚だけ持ち、指数移動平均で更新します:
はジッタ付きの新しいフレームで、は普通0.1程度です。
フレームは、最終的に重みを持ちます。
での計算例:
- 現在のフレームと其の前の4フレームの重みは0.1、0.09、0.081、0.0729、0.0656です。
- 各フレームの値が分散のノイズを持つなら(ジッタが変わる度に境目のピクセルが内と外を行き来する場合)、平均の分散はで、フレームを等しく平均したのと同じです。
- 急な変化の後、フレームで新しい値のに届きます。5フレームで0.41、10フレームで0.65、22フレームで0.90で、60 fpsなら約3分の1秒です。
を小さくすると滑らかになりますが反応が遅くなり、動きの中ではゴーストとぼけになります。
此れがTAAの中心的なトレードオフです。
モーションベクトルによる再投影
物が動くと、ピクセルの履歴は別の物を映しています。
其の為、レンダラーはピクセルごとにモーションベクトルを書き出します。
見えている面が前のフレームからどれだけ動いたかで、各頂点を今のフレームと前のフレームの行列(どちらもジッタ無し)で変換し、画面上の位置の差を取って求めます。
TAAは、其の面が前にあった場所で履歴を読みます。
此れが再投影(リプロジェクション)です。
計算例。 、ピクセルなら、履歴はで読みます。
ピクセル中心の間なので、バイリニアかバイキュービック(Catmull–Rom)のフィルタで読みます。
此の再標本化は毎フレーム少しずつぼかし、ぼけが積み重なるので、TAAの画像はシャープ化のパス無しではソフトに見えます。
履歴の棄却:近傍クランプ
再投影は、ディスオクルージョン(前のフレームでは隠れていた面)、照明やテクスチャが変わった時、正しいモーションベクトルの無いエフェクトで失敗します。
其の間違った履歴を混ぜると、動く物体の後ろに薄れて行く尾が残ります。
此れがゴースト(ゴースティング)です。
標準的な対策は近傍クランプです。
現在の3×3の近傍が「今此処であり得る色」を教えてくれるので、ブレンドの前に履歴を其の9色の最小と最大の間にクランプします。
計算例(1チャンネル)。
近傍の値は、中心はで、最小0.20、最大0.55です。
再投影した履歴はで、立ち去った明るい物体が残した物です。
クランプ無しではで、明るいゴーストです。
0.55にクランプするとで、ゴーストはすぐに消えます。
分散クリッピング(Marco Salvi、2016年)はもっときつく、近傍の平均と標準偏差を使ってに切り詰めます。
此処では、なので、なら履歴は約0.414に切り詰められます。
クランプは普通YCoCg(ルーマと2つの色差)で行います。
RGBより箱が色にぴったり合うからです。
代償はちらつきです。
ジッタした一部のフレームにしか現れないサブピクセルの細部は、毎フレーム範囲を変えてしまいます。
TAAのリゾルブの核心部分です(モーションベクトルはUV単位):
// One pixel of a TAA resolve. motion is in UV units (this frame minus last frame).
float3 taaResolve(Texture2D<float4> current, Texture2D<float4> history, SamplerState linearClamp,
                  int2 pixel, float2 uv, float2 motion, float alpha) {
  uint w, h;
  current.GetDimensions(w, h);
  int2 size = int2(w, h);
  float3 c = current.Load(int3(pixel, 0)).rgb;
  float3 lo = c;
  float3 hi = c;
  for (int y = -1; y <= 1; ++y) {
    for (int x = -1; x <= 1; ++x) {
      int2 q = clamp(pixel + int2(x, y), int2(0, 0), size - 1);
      float3 n = current.Load(int3(q, 0)).rgb;
      lo = min(lo, n);
      hi = max(hi, n);
    }
  }
  float3 past = history.SampleLevel(linearClamp, uv - motion, 0).rgb;
  past = clamp(past, lo, hi);
  return lerp(past, c, alpha);
}
// One pixel of a TAA resolve. motion is in UV units (this frame minus last frame).
vec3 taaResolve(sampler2D current, sampler2D history, ivec2 pixel, vec2 uv, vec2 motion,
float alpha) {
ivec2 size = textureSize(current, 0);
vec3 c = texelFetch(current, pixel, 0).rgb;
vec3 lo = c;
vec3 hi = c;
for (int y = -1; y <= 1; ++y) {
for (int x = -1; x <= 1; ++x) {
ivec2 q = clamp(pixel + ivec2(x, y), ivec2(0), size - 1);
vec3 n = texelFetch(current, q, 0).rgb;
lo = min(lo, n);
hi = max(hi, n);
}
}
vec3 past = texture(history, uv - motion).rgb;
past = clamp(past, lo, hi);
return mix(past, c, alpha);
}// One pixel of a TAA resolve. motion is in UV units (this frame minus last frame).
float3 taaResolve(Texture2D<float4> current, Texture2D<float4> history, SamplerState linearClamp,
int2 pixel, float2 uv, float2 motion, float alpha) {
uint w, h;
current.GetDimensions(w, h);
int2 size = int2(w, h);
float3 c = current.Load(int3(pixel, 0)).rgb;
float3 lo = c;
float3 hi = c;
for (int y = -1; y <= 1; ++y) {
for (int x = -1; x <= 1; ++x) {
int2 q = clamp(pixel + int2(x, y), int2(0, 0), size - 1);
float3 n = current.Load(int3(q, 0)).rgb;
lo = min(lo, n);
hi = max(hi, n);
}
}
float3 past = history.SampleLevel(linearClamp, uv - motion, 0).rgb;
past = clamp(past, lo, hi);
return lerp(past, c, alpha);
}
lerp(past, c, alpha)もmix(past, c, alpha)も、つまり上の移動平均を計算します。
実際の実装は、YCoCg、バイキュービックでの履歴の読み込み、動きに応じた、シャープ化を加えます。
長所、アーティファクト、アップスケーリング
TAAはフルスクリーンのパス1回程度で、全ての種類のエイリアシング(輪郭、シェーディング、鏡面反射、サブピクセルの細部)を扱います。
更に、スクリーンスペースのアンビエントオクルージョンやレイトレーシングの反射の様に、1フレームでは疎にしか標本化されないエフェクトもきれいにします(第24章)。
其の為、現代のエンジンはTAAを前提に作られています。
典型的なアーティファクトは、ゴースト、ぼけ、細い物のちらつき、そしてモーションベクトルの無い物(パーティクル、スクロールするテクスチャ)の滲みです。
サンプルを時間に広げると、出力が入力と同じ解像度である必要はなくなります。
低い解像度でジッタ付きで描き、大きな履歴に蓄積すれば良いのです。
此れが時間方向アップスケーリングで、執筆時点ではAMDのFSR 2以降、NVIDIAのDLSS 2以降、IntelのXeSSの原理です。
DLSS、XeSS、FSR 4は手書きの棄却規則の一部又は全部をニューラルネットワークに置き換えており、FSR 2と3は手書きの規則の儘です。
第29章で扱います。
20.7 鏡面反射のエイリアシング
法線マップを貼った光沢面は、此処までの全ての手法を打ち負かします。
1ピクセルの中で凸凹は様々な方向を向いているのに、シェーダーはミップマップの1つのレベルから1つの法線しか見ないので、ハイライトは有るか無いかのどちらかになり、カメラが動くと瞬きます。
多くの違う法線の平均は短いベクトルです。
其れを正規化すると、鋭いハイライトを持つ滑らかな鏡を表してしまいますが、ピクセルの下の面は本当は粗く、ハイライトは広く暗いはずです。
Toksvigの手法(Michael Toksvig、NVIDIA、2004年)は、此の短さを情報として使います。
平均した正規化前の法線をとすると、ブリン・フォンの指数(第10章)をToksvig係数で小さくします:
計算例。 とを平均すると、長さは0.8です。
なら、です。
とても広く暗いハイライトで、凸凹の面を遠くから見た時の見え方です。
法線が揃っている所ではなので、何も変わりません。
物理ベースの材質(第22章)では、同じ考えがラフネスフィルタリングになります。
各ミップレベルのラフネスを、其のレベルが平均した法線の分散だけ大きくするのです。
法線のスクリーンスペースの微分から、ピクセルごとにラフネスを広げるエンジンもあります。
教訓は、テクスチャだけでなく材質をプリフィルタする事です。
検定のポイント
第2章と第6章のアンチエイリアシングに繋がる点です:
- プリフィルタリング(エリアサンプリング、ミップマップ)は標本化の前に高い周波数を取り除き、ポストフィルタリング(スーパーサンプリング、MSAA、TAA)は多く標本化してから後でフィルタをかけます。
- SSAAは全てのサンプルをシェーディングします。MSAAはカバレッジと深度をサンプルごとに判定しますが、シェーディングはピクセルごと・三角形ごとに1回です。輪郭と交差線は滑らかになりますが、シェーディングとアルファテストのエイリアシングは残ります。
- ポストプロセスAAは完成した画像に対して働き(安価、サブピクセルの細部は戻せない)、TAAはジッタしたフレームを再投影と履歴のクランプで蓄積します(ゴーストとぼけが其のアーティファクト)。
20.8 リアルタイムの透明表現:問題を振り返る
物体単位と三角形単位の並べ替え
10.12節では、over演算子が順番に依存する事を見ました。
半透明の面は、不透明な面の後に、深度の書き込みを無効にして奥から手前へ混ぜなければなりません。
順番はピクセルごとに正しくなければならないのに、GPUは三角形を届いた順に描きます。
エンジンは出来る範囲で並べ替えます:
- 物体単位:各物体の中心の距離で、毎フレーム並べ替えます。安価ですが、交わる物体や循環して重なる物体(10.2節)、大きな物体では間違えます。
- 三角形単位:例えば、幾つかの視線方向に沿って前もって並べたインデックスバッファを持ち、今の視線に一番近い物を選びます。ガラスの物体1つには良いですが、三角形同士が交わる所ではやはり間違えます。
- 裏面を先に:閉じた物体の裏面を描いてから表面を描くと、凸な形の内側では正しい順番になります。
どれも正確ではありません。
順序非依存の半透明(OIT)とは、結果が送られた順番に依存しない手法の事です。
乗算済みアルファとアンダー演算
OITの手法の幾つかは、手前から奥へ合成します。
乗算済みアルファ(第14章の14.10節)では、フラグメントをとして保存し、overは保存した色を其のまま足すになります。
GPUではブレンド係数(ONE、ONE_MINUS_SRC_ALPHA)です。
手前から奥へ合成する時は、蓄積した乗算済みの色(0から始める)と、其れまでの手前の全ての透過率(1から始める)を持ちます:
最後に背景を足します:。
此れがアンダー演算です。
第10章のガラスでの計算例です。
青が赤の手前にあり、どちらも、背景は白です。
青で、、赤で、、背景がを足してです。
10.12節の「赤が先、次に青」の結果と完全に同じです。
アンダーとoverはリストの反対の端から始めるだけで同じ絵になり、手前から奥へならが殆ど0になった所で打ち切れます。
共通の例
以下の節では、1つのピクセルに3つのフラグメントが此の順に届く例を使います。
背景は白です:
| 到着順 | 色 | 距離 | |
|---|---|---|---|
| 1 | 赤 (1, 0, 0) | 0.4 | 4 |
| 2 | 青 (0, 0, 1) | 0.8 | 6 |
| 3 | 緑 (0, 1, 0) | 0.5 | 3 |
手前から奥へ(緑、赤、青)並べてアンダーで合成します:
- 緑:、
- 赤:、
- 青:、
- 背景:
此れが正確な答えです。
届いた順にoverで混ぜるとになり、青過ぎます。
奥にある殆ど不透明な青いガラスを、赤の上に混ぜてしまったからです。
20.9 デプスピーリング
デプスピーリング(Cass Everitt、NVIDIA、2001年)は、半透明の形状を何度も描き、1パスに1層ずつ「剥がす」事で、深度テストだけでピクセルごとの順番を求めます:
- パス1:普通の深度テストで描きます。深度バッファには、ピクセルごとに一番手前の半透明の面が残ります。此れがレイヤー1です。
- パスk:前のレイヤーの深度をテクスチャに入れて、もう一度描きます。シェーダーは、前のレイヤーより奥に無いフラグメントを捨てます。残りの中から、普通の深度テストが一番手前を残します。此れがレイヤーkです。
- 各パスの後、新しいレイヤーを其れまでのレイヤーの下に(手前から奥へ)合成します。
- フラグメントが1つも出ないパス(オクルージョンクエリで数えます)か、決めた回数で止めます。
不透明な形状を先に描き、其の深度もパスを制限するので、其の陰に隠れた物は剥がされません。
計算例。 共通の例で、フラグメントは毎パス赤、青、緑の順に届きます:
| パス | 捨てる条件:深度 ≤ | 赤 (4) | 青 (6) | 緑 (3) | レイヤー | アンダー後のC | T |
|---|---|---|---|---|---|---|---|
| 1 | (無し) | 書き込み(バッファは空) | 失敗 (6 > 4) | 勝ち (3 < 4) | 緑、3 | (0, 0.5, 0) | 0.5 |
| 2 | 3 | 書き込み | 失敗 (6 > 4) | 捨てる (3 ≤ 3) | 赤、4 | (0.2, 0.5, 0) | 0.3 |
| 3 | 4 | 捨てる (4 ≤ 4) | 書き込み | 捨てる | 青、6 | (0.2, 0.5, 0.24) | 0.06 |
| 4 | 6 | 捨てる | 捨てる | 捨てる | 無し:停止 |
背景を足すとで、間違った順番で送られた形状から、並べ替えた結果が得られました。
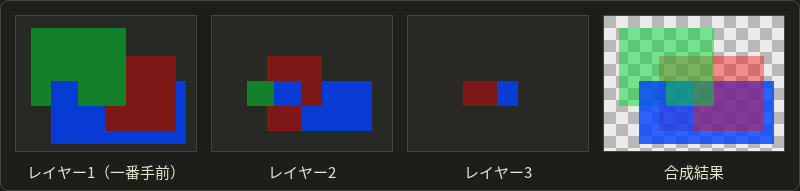
図では傾いた青の四角形が他の2枚を貫通しているので、各四角形の内側でレイヤーの順番が変わります。
物体単位の並べ替えでは正しく出来ませんが、デプスピーリングはピクセルごとに正しく出来ます。
コストはパスの数です。
半透明のレイヤーが8枚なら、全ての半透明の形状を8回描き、更に何も見つからない1回が要ります。
デュアルデプスピーリング(Louis BavoilとKevin Myers、NVIDIA、2008年)は、深度の最小/最大ブレンドで手前と奥を同じパスで剥がすので、層が約パス、8層なら5パスで済みます。
デプスピーリングは、速さより正確さが大事な所(CAD、科学的可視化)や、速い手法を確かめる為の正解として今も使われています。
20.10 ピクセルごとの連結リスト:GPU上のAバッファ
第10章の10.7節のAバッファは、ピクセルごとにフラグメントのリストを持ち、並べ替えてから合成します。
2010年頃から、GPUはシェーダーのアトミック操作を使って、此の様なリストを1パスで作れる様になりました(Jason Yang、Justin Hensley、Holger Grün、Nicolas Thibieroz、「Real-Time Concurrent Linked List Construction on the GPU」、2010年)。
必要なバッファは3つです。
先頭ポインタ画像(ピクセルごとに32ビットの添え字1つ、毎フレーム「終端」の値でクリア)、ノードプール(色、深度、次のノードの添え字を持つノードの大きなバッファ1つ)、そして使ったノードのカウンタです。
半透明のフラグメントは其々、どんな順番でも、何千もの他のフラグメントと並列に、次の事を行います:
index = atomicAdd(counter, 1)でノードを確保します。古い値を返して1増やすので、2つのフラグメントが同じ添え字を得る事はありません(プールが一杯ならフラグメントを捨てます)。oldHead = atomicExchange(head[pixel], index)で、其のピクセルのリストの先頭に繋ぎます。- ノードに色、深度、
next = oldHeadを書き込みます。
リストは到着の逆順になります。
図では、ピクセルPのフラグメントは赤、青、緑の順に届き、ノード0、2、5を得ました(其の間に他のピクセルが1、3、4を取りました)。
従ってPのリストは5(緑、3)→ 2(青、6)→ 0(赤、4)→ 終端です。
不透明な形状を先に描き、半透明のシェーダーは早期深度テスト(GLSLではlayout(early_fragment_tests) in;、SlangとHLSLでは[earlydepthstencil])を使うべきです。
隠れたフラグメントがノードを確保しない様にする為です。
struct FragmentNode {
  uint color;   // premultiplied RGBA, 8 bits per channel
  float depth;
  uint next;    // index of the next node, or END
};

static const uint END = 0xFFFFFFFF;

RWTexture2D<uint> heads;                 // cleared to END every frame
RWStructuredBuffer<FragmentNode> nodes;  // the shared node pool
RWStructuredBuffer<uint> counter;        // counter[0] = nodes used, cleared to 0

uint packColor(float4 c) {
  uint4 u = uint4(saturate(c) * 255.0 + 0.5);
  return u.r | (u.g << 8) | (u.b << 16) | (u.a << 24);
}

void insertFragment(uint2 pixel, float4 premul, float depth, uint capacity) {
  uint index;
  InterlockedAdd(counter[0], 1, index);
  if (index >= capacity)
    return;                              // pool full: drop the fragment
  uint oldHead;
  InterlockedExchange(heads[pixel], index, oldHead);
  FragmentNode n;
  n.color = packColor(premul);
  n.depth = depth;
  n.next = oldHead;
  nodes[index] = n;
}
struct FragmentNode {
uint color; // premultiplied RGBA, 8 bits per channel
float depth;
uint next; // index of the next node, or END
};
const uint END = 0xFFFFFFFFu;
layout(set = 0, binding = 0, r32ui) uniform coherent uimage2D heads; // cleared to END
layout(set = 0, binding = 1, std430) buffer Nodes { FragmentNode nodes[]; };
layout(set = 0, binding = 2, std430) buffer Counter { uint counter; }; // cleared to 0
uint packColor(vec4 c) {
uvec4 u = uvec4(clamp(c, 0.0, 1.0) * 255.0 + 0.5);
return u.r | (u.g << 8) | (u.b << 16) | (u.a << 24);
}
void insertFragment(ivec2 pixel, vec4 premul, float depth, uint capacity) {
uint index = atomicAdd(counter, 1u);
if (index >= capacity)
return; // pool full: drop the fragment
uint oldHead = imageAtomicExchange(heads, pixel, index);
nodes[index].color = packColor(premul);
nodes[index].depth = depth;
nodes[index].next = oldHead;
}struct FragmentNode {
uint color; // premultiplied RGBA, 8 bits per channel
float depth;
uint next; // index of the next node, or END
};
static const uint END = 0xFFFFFFFF;
RWTexture2D<uint> heads; // cleared to END every frame
RWStructuredBuffer<FragmentNode> nodes; // the shared node pool
RWStructuredBuffer<uint> counter; // counter[0] = nodes used, cleared to 0
uint packColor(float4 c) {
uint4 u = uint4(saturate(c) * 255.0 + 0.5);
return u.r | (u.g << 8) | (u.b << 16) | (u.a << 24);
}
void insertFragment(uint2 pixel, float4 premul, float depth, uint capacity) {
uint index;
InterlockedAdd(counter[0], 1, index);
if (index >= capacity)
return; // pool full: drop the fragment
uint oldHead;
InterlockedExchange(heads[pixel], index, oldHead);
FragmentNode n;
n.color = packColor(premul);
n.depth = depth;
n.next = oldHead;
nodes[index] = n;
}
其の後、フルスクリーンのリゾルブパスが各リストを辿り、ノードを小さなローカル配列(例えば最大16個)にコピーし、深度で並べ替え(こんなに短いリストには挿入ソートが一番速いです)、不透明な画像の上に合成します。
ピクセルPでは、緑、青、赤の順に読み、緑、赤、青に並べ替え、20.8節と同じを得ます。
メモリの計算。 ノード1つはバイトです。
1920×1080で、半透明のフラグメントがピクセルあたり平均4個なら、プールはノード、バイト、約94.9 MiBが要り、更に先頭ポインタに7.9 MiBが要ります。
本当の問題は、数が前もって分からない事です。
カメラの前のパーティクルは、1フレームで1ピクセルに50個のフラグメントを作る事もあり、溢れたプールはフラグメントを捨てて穴を残します。
エンジンは最悪の場合に合わせて確保するか、溢れた後にプールを大きくするか、ピクセルごとに一番手前の個だけを残します(kバッファ)。
kバッファは、ピクセルのフラグメントシェーダーの実行順を保証する新しいハードウェア機能(Direct3D 12のラスタライザー順序ビュー、Vulkanのフラグメントシェーダーインターロック)で実用的になりました。
連結リストは、何も捨てられない限り、1回の形状のパスで正確です。
20.11 重み付きブレンドによる順序非依存の半透明
正確さを諦める
正確な手法には、多くのパスか、上限の無いメモリが要ります。
重み付きブレンドOIT(WBOIT、Morgan McGuireとLouis Bavoil、Journal of Computer Graphics Techniques、2013年)は逆の道を取ります。
1パス、レンダーターゲット2枚、固定のメモリ、そして順番を全く持たない近似です。
正確な結果の内、2つは順番に依存しません。
背景がどれだけ隠れるかと、背景の寄与です。
順番に依存するのは、覆われた部分の中の色の混ざり方だけです。
WBOITは其の混ざり方を重み付き平均で置き換えます:
重みはです。
和と積は可換なので、固定機能のブレンディングがどんな順番でも蓄積出来ます:
- 蓄積ターゲット(RGBA16F、0でクリア、ブレンド
ONE、ONE):各フラグメントがを足します。 - リビーリッジターゲット(R8かR16F、1でクリア、ブレンド
ZERO、ONE_MINUS_SRC_COLOR):各フラグメントがを書き、ブレンドが保存された値にを掛けます。 - フルスクリーンの合成パスが和を割り、リビーリッジを背景の重みとして、平均を不透明な画像の上に混ぜます。
不透明な形状に対する深度テストは有効のまま、深度の書き込みは無効のままです。
なら色は不透明度で平均されるだけです。
論文の洞察は、を距離と共に小さくして、現実と同じく近い面が支配する様にした事です。
提案された重み関数の1つは、ビュー空間の距離に対して次の通りです:
16ビット浮動小数点のターゲットと0.1〜500の距離に合わせて調整されています。
此の例の距離ではとの項は無視出来るので、です。
計算例
共通の例です。
赤が距離4、青が6、緑が3、背景は白です。
リビーリッジはなので、レイヤーは0.94を覆い、並べ替えた結果と完全に同じです。
の場合、平均は色をで重み付けします:
正確な答えはでした。
手前にある緑が支配するべきなのに、一番不透明な青が支配しています。
深度の重みの場合:緑は、赤は、青はです。
(の中)と、もう一度(乗算済みの色)を掛けると、取り分は緑、赤、青、合計13.889です:
ずっと近くなり、チャンネルごとの最大の誤差は0.224から0.061に下がります。
重みは、レイヤーが深さ方向に散らばっていて、あまり不透明でない時に上手く行く経験則です。
どんな重み付き平均も、「手前のレイヤーが奥のレイヤーを隠す」事は表せません。
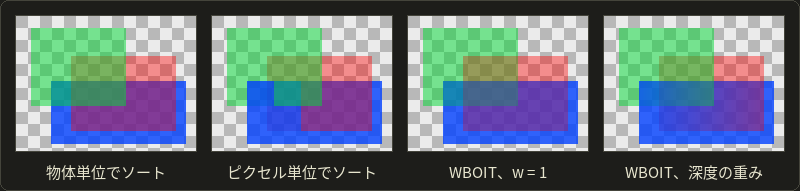
画像全体では、チャンネルごとの平均誤差は、物体単位の並べ替えが約0.018ですが、大きな間違った領域に集中しています(最大0.48)。
は0.029、深度の重みは0.020で、薄く広がっています(最大は其々0.32と0.22)。
WBOITは物体の順番が入れ替わっても絵が飛びません。
決してちらつかない誤差は、飛ぶ正しい絵より普通は目立たないので、ゲームのパーティクル、煙、草木、ガラスによく使われます。
struct OitOutput {
  float4 accum : SV_Target0;     // blend ONE, ONE; cleared to 0
  float revealage : SV_Target1;  // blend ZERO, ONE_MINUS_SRC_COLOR; cleared to 1
};

// premul = (alpha * color, alpha); viewDepth = distance from the camera
OitOutput oitAccumulate(float4 premul, float viewDepth) {
  float d = viewDepth / 5.0;
  float w = premul.a * clamp(10.0 / (1e-5 + d * d + pow(viewDepth / 200.0, 6.0)), 1e-2, 3e3);
  OitOutput o;
  o.accum = premul * w;
  o.revealage = premul.a;
  return o;
}layout(location = 0) out vec4 outAccum; // blend ONE, ONE; cleared to 0
layout(location = 1) out float outRevealage; // blend ZERO, ONE_MINUS_SRC_COLOR; cleared to 1
// premul = (alpha * color, alpha); viewDepth = distance from the camera
void oitAccumulate(vec4 premul, float viewDepth) {
float d = viewDepth / 5.0;
float w = premul.a * clamp(10.0 / (1e-5 + d * d + pow(viewDepth / 200.0, 6.0)), 1e-2, 3e3);
outAccum = premul * w;
outRevealage = premul.a;
}struct OitOutput {
float4 accum : SV_Target0; // blend ONE, ONE; cleared to 0
float revealage : SV_Target1; // blend ZERO, ONE_MINUS_SRC_COLOR; cleared to 1
};
// premul = (alpha * color, alpha); viewDepth = distance from the camera
OitOutput oitAccumulate(float4 premul, float viewDepth) {
float d = viewDepth / 5.0;
float w = premul.a * clamp(10.0 / (1e-5 + d * d + pow(viewDepth / 200.0, 6.0)), 1e-2, 3e3);
OitOutput o;
o.accum = premul * w;
o.revealage = premul.a;
return o;
}
合成パスは、色とアルファ=リビーリッジを出力し、ブレンド係数(ONE_MINUS_SRC_ALPHA、SRC_ALPHA)で混ぜます。
此れで、つまり上の式になります。
2つのターゲットは違うブレンド設定が必要ですが、現在のAPIは全て其れを許しています。
20.12 其の他の手法と比較
更に3つの手法を、名前だけでも知っておく価値があります:
- モーメントベースOIT(Cedrick Münstermann、Stefan Krumpen、Reinhard Klein、Christoph Peters、2018年):最初のパスで、各ピクセルで吸収()が深さ方向にどう分布しているかのモーメントを幾つか保存します。2番目のパスで、其処から各フラグメントの手前の透過率を再構成し、其れで合成します。WBOITと同じく固定のメモリですが、並べ替えた結果にずっと近くなります。
- 確率的透明(Eric Enderton、Erik Sintorn、Peter Shirley、David Luebke、2010年):を、面がMSAAの各サンプルを覆う確率として扱い(ランダムなマスクによるアルファトゥカバレッジ)、サンプルごとの普通の深度テストを使います。順序非依存で平均すれば正しいですが、十分なサンプルやフレームを平均するまではノイズが出ます。
- レイトレーシング:ハードウェアのレイトレーシングなら、各レイに沿って半透明の交点を順番に見つけ、屈折も出来ます(第12章)。但し、重いパーティクルのエフェクトにはまだ高過ぎます。
| 手法 | 形状のパス数 | メモリ | 正確? | 主な用途 |
|---|---|---|---|---|
| 物体単位の並べ替え | 1 | 追加無し | いいえ(交差、循環) | 殆どのエンジンの標準 |
| デプスピーリング | レイヤー数 + 1 | 深度バッファ2枚、色 | はい | CAD、可視化、参照画像 |
| デュアルデプスピーリング | 約 レイヤー数/2 + 1 | 最小/最大深度、色 | はい | 同上、より速い |
| ピクセルごとの連結リスト | 1 + リゾルブ | フラグメントと共に増える | はい(プールが溢れなければ) | 髪、ガラス、可視化 |
| 重み付きブレンドOIT | 1 + 合成 | レンダーターゲット2枚 | いいえ(色の混ざり方が近似) | パーティクル、煙、草木 |
| モーメントベースOIT | 2 + 合成 | モーメントのターゲット数枚 | いいえ(近い) | ゲーム、可視化 |
| 確率的透明 | 1以上、MSAA付き | MSAAのバッファ | 平均すれば(ノイズあり) | 髪、草木、TAAと併用 |
エンジンは此れらを組み合わせます。
標準は物体単位の並べ替え、パーティクルや髪にはOIT、水の入ったグラスの様な一部の物には専用の工夫、と言った具合です。
ブレンディングと並べ替えは、OpenGLシリーズの第16章で自分で設定します。
検定のポイント
第10章の半透明と第14章の合成に繋がる点です:
- overは順番に依存します。半透明の面は不透明な面の後に、深度テストは有効、深度の書き込みは無効で、奥から手前へ描きます。加算ブレンディングは順番に依存しません。
- アンダーで手前から奥へ(、)合成しても、overで奥から手前へ合成したのと同じ結果になります。
- Aバッファ(GPU版はピクセルごとの連結リスト)とデプスピーリングは正確です。重み付きブレンドOITは覆う割合は正確ですが、色の混ざり方は近似です。
20.13 まとめ
- リアルタイムのエイリアシングは、形状、シェーディング、テクスチャ(ミップマップで対処)、時間から来ます。対策はプリフィルタリングか、サンプルを増やして再構成フィルタ(ボックス、テント、ガウス、ミッチェル・ネトラバリ)でまとめる事です。
- SSAAは全てのサンプルをシェーディングし、倍のコストで全てを直します。回転した配置は、ほぼ垂直とほぼ水平の輪郭に段階を与えます。
- MSAAはカバレッジと深度を個の標準サンプル位置で判定しますが、シェーディングはピクセルごと・三角形ごとに1回で、最後にリゾルブします。輪郭と交差線は滑らかになりますが、シェーディングとアルファテストのエイリアシングは残ります(サンプルシェーディングとアルファトゥカバレッジが助けになります)。メモリはSSAAと同じで、ディファードシェーディングでは高く付きます。
- MLAA、FXAA、SMAAは完成した画像から階段を見つけ、推測した輪郭に沿って混ぜます。安価ですが、サブピクセルの細部が見えず、動きに弱いです。
- TAAはハルトン列で投影をジッタさせ、モーションベクトルで履歴を再投影し、現在の近傍にクランプし、指数移動平均で混ぜます。ゴーストとぼけを代償に全てのエイリアシングを扱い、時間方向アップスケーラーの土台です。
- 鏡面反射のエイリアシングは材質をプリフィルタして直します(Toksvig係数、ラフネスフィルタリング)。
- 透明表現にはピクセルごとの順番が要ります。並べ替えは近似で、デプスピーリング(レイヤーごとに1パス)とピクセルごとの連結リスト(1パス、上限の無いメモリ)は正確、重み付きブレンドOITは1パスで固定のメモリ、色の混ざり方は近似ですが安定しています。
20.14 用語
| English | 日本語 |
|---|---|
| geometric aliasing | 幾何学的エイリアシング |
| shading aliasing / specular aliasing | シェーディングのエイリアシング/鏡面反射のエイリアシング |
| temporal aliasing | 時間方向のエイリアシング |
| reconstruction filter | 再構成フィルタ |
| box filter / tent filter | ボックスフィルタ/テントフィルタ |
| Gaussian filter | ガウシアンフィルタ |
| Mitchell–Netravali filter | ミッチェル・ネトラバリフィルタ |
| supersampling (SSAA) | スーパーサンプリング |
| ordered grid / rotated grid | 格子配置/回転格子 |
| multisample anti-aliasing (MSAA) | マルチサンプルアンチエイリアシング |
| standard sample locations | 標準サンプル位置 |
| coverage, coverage mask | カバレッジ(被覆率)、カバレッジマスク |
| resolve | リゾルブ |
| centroid sampling | セントロイドサンプリング |
| sample-rate shading | サンプルシェーディング |
| alpha to coverage | アルファトゥカバレッジ |
| post-process anti-aliasing (MLAA, FXAA, SMAA) | ポストプロセスアンチエイリアシング |
| luma, local contrast | ルーマ、局所コントラスト |
| temporal anti-aliasing (TAA) | 時間方向アンチエイリアシング(TAA) |
| jitter | ジッタ |
| Halton sequence, low-discrepancy sequence | ハルトン列、低食い違い量列 |
| exponential moving average | 指数移動平均 |
| history | 履歴 |
| motion vector | モーションベクトル |
| reprojection | 再投影(リプロジェクション) |
| disocclusion | ディスオクルージョン |
| neighborhood clamping, variance clipping | 近傍クランプ、分散クリッピング |
| ghosting | ゴースト(ゴースティング) |
| temporal upscaling | 時間方向アップスケーリング |
| Toksvig factor, roughness filtering | Toksvig係数、ラフネスフィルタリング |
| order-independent transparency (OIT) | 順序非依存の半透明(OIT) |
| under operator | アンダー演算 |
| transmittance | 透過率 |
| depth peeling, dual depth peeling | デプスピーリング、デュアルデプスピーリング |
| per-pixel linked list | ピクセルごとの連結リスト |
| atomic operation | アトミック操作 |
| weighted blended OIT | 重み付きブレンドOIT |
| accumulation, revealage | 蓄積、リビーリッジ(背景の見える割合) |
| moment-based OIT | モーメントベースOIT |
| stochastic transparency | 確率的透明(ストキャスティック透明) |
20.15 課題
- ★ 2560×1440のフレームが、サンプルごとにRGBA16Fの色(8バイト)と32ビットの深度(4バイト)を持つ8× MSAAを使います。サンプルバッファは何バイト、何MiBで、1サンプルのRGBA16Fのリゾルブ先はどれだけ加わりますか? 8× SSAAなら1フレームにフラグメントシェーダーを何回実行しますか?
- ★ ハルトン列の点9〜12(基数2と3)を桁の鏡写しで求め、ピクセル単位のジッタと、2560×1440の画面でのNDCの平行移動量を求めて下さい。ハルトン列の図に書き込み、最初の8点の隙間を埋める事を確かめて下さい。
- ★★ 段の長さが8ピクセルの階段があります。MLAAの計算例に倣って、段の中点を通る輪郭を再構成し、1段の8ピクセルのブレンドの重みを求めて下さい。重みが左右対称で、図形の総面積が保たれる事を確かめて下さい。
- ★★ TAAが0.1の代わりにを使います。最後の4フレームの重み、等しく平均した場合に相当するフレーム数、新しい値の90%に届くまでのフレーム数を求めて下さい。次に、ジッタしたフレームの半分にしか映らない細い電線に、近傍クランプが何をするかを説明して下さい。
- ★★★ 乗算済みの2つのレイヤーを手前から奥へアンダーで合成した結果が、奥から手前へoverで合成した結果と等しい事を式で示して下さい。次に、全てのレイヤーが同じ色なら重み付きブレンドOITが正確になる事を示し、大きく間違える2レイヤーの例(殆ど不透明な手前のレイヤーと、違う色の奥のレイヤー)を作って下さい。での誤差を計算し、深度の重みで其れがどう変わるかを述べて下さい。
選択問題
問1 ★ 次のうち、MSAAについて正しい物はどれか。
| あ | MSAAはサンプルごとにフラグメントシェーダーを1回実行するので、4× MSAAのシェーディングのコストは4× SSAAと同じである。 |
| い | MSAAは、三角形の内側の鏡面反射のエイリアシングや其の他のシェーディングのエイリアシングも取り除く。 |
| う | 4× MSAAで大きくなるのは深度バッファだけで、カラーバッファはMSAA無しと同じメモリで済む。 |
| え | MSAAは、追加のメモリも追加のライティングの仕事も無しに、ディファードシェーディングで使える。 |
| お | MSAAは1ピクセルの複数のサンプル点でカバレッジと深度を判定するが、フラグメントシェーダーは普通、其のピクセルを覆う三角形ごとに1回だけ実行する。 |
問2 ★ 次のうち、時間方向アンチエイリアシング(TAA)について正しい物はどれか。
| あ | TAAは毎フレーム、1ピクセルに複数のサンプルを描き、其のフレームの中で平均する。 |
| い | TAAは毎フレーム違うサブピクセルのずれで投影をずらし、現在のフレームを、モーションベクトルで再投影した履歴と混ぜる。 |
| う | TAAは、カメラだけが動く限り、モーションベクトルを必要としない。 |
| え | 履歴を現在の近傍の色の範囲にクランプするのは、履歴の重みを増やしてより多くのフレームを平均する為である。 |
| お | FXAAの様なポストプロセス手法と違い、TAAは決してゴーストやぼけを生まない。 |
問3 ★★ あるピクセルに、赤と青の2つの半透明のフラグメントがあり、どちらもで、背景は黒である。重みを全てとした重み付きブレンドOITの結果の色はどれか。
| あ | (0.375, 0, 0.375) |
| い | (0.25, 0, 0.5) |
| う | (0.5, 0, 0.25) |
| え | (0.5, 0, 0.5) |
| お | (0.75, 0, 0.75) |
20.16 実践課題
1つのピクセルを手でアンチエイリアスし、合成する。
方眼紙、定規、色鉛筆、電卓を用意して下さい。
1つのピクセルを、1サンプルの描画、4× MSAA、8フレームのTAAのジッタで追い掛け、次に半透明のピクセルを3通りに合成し、全てを正確な答えと比べます。
ピクセルは単位正方形で、原点は左上の角、yは下向きです。
2つの三角形が直線で接しています。
三角形Bは直線の上の部分()、三角形Aは下の部分です。
Aはオレンジ、Bは青です。
- 描く。 ピクセルを10 cmの正方形で描き、からへの直線を引き、Bを塗ります。ピクセル中心と、20.4節の4×標準配置の4つのサンプル位置に0〜3の番号を付けて印を付けて下さい。
- 正確な覆い具合。 Bの面積(台形です)と、面積で重み付けしたピクセルの正確な色を求めて下さい。
- 1サンプル。 ピクセル中心を覆う三角形を決め、1ピクセル1サンプルでの色を書いて下さい。
- 4× MSAA。 各サンプルをで判定し、2つのカバレッジマスクを4ビットの数で書き、フラグメントシェーダーが何回走るかを答え、リゾルブした色を求め、Bのシェーダーがセントロイドサンプリング有りと無しで何処で評価されるかを述べて下さい。
- TAA。 最初の8つのハルトン点(基数2と3)を桁の鏡写しで自分で求め、ピクセルに書き込み、Bに入る数を数え、8つの1サンプルの結果を等しい重みで平均して下さい。
- 半透明、並べ替えあり。 別のピクセルに、黒い背景の上で3つの半透明のフラグメントが、黄が距離5、シアンが距離2、マゼンタが距離3の順に届きます。は全て0.5です。奥から手前へoverで、手前から奥へアンダーで(各フラグメントの後のとを書きます)、そして到着順にoverで合成して下さい。
- デプスピーリングと連結リスト。 到着順に対して、20.9節の様なパスの表を作って下さい。次に、3回の挿入後(到着順にノード0、1、2)の先頭ポインタとノードプールを描き、リゾルブが読む順番を書いて下さい。
- WBOIT。 での重み付きブレンドOITの結果を求め、並べ替えた結果と比べて下さい。式の何処が正確で、何が失われましたか?
自分で確かめる方法:
- 手順2のBの面積は、両端での直線の高さの平均です。正確な色はAとBの間にあり、Aに近くなります。
- 手順4では、2つのマスクを合わせると4ビット全てが立ち、重なるビットはありません。MSAAの色は、サンプル数で重み付けしたAとBの平均です。
- 手順5では、8つのxの値は全て違うの倍数で、Bの覆い具合の見積もりは、1サンプルの結果よりずっと手順2に近くなります。
- 手順6では、overとアンダーが一致し、残った透過率はです。到着順の結果は異なります。
- 手順7では、レイヤーは手前から順に出て来て、最後のレイヤーの次のパスは何も見つけず、リストは到着の逆順に読まれます。
- 手順8では、が手順6のと等しく、3つの色が等しい重みで平均されるので、WBOITの色は灰色になります。
コメント(0)
まだコメントはありません。
ログインするとコメント出来ます。