7. 行列の積と転置
第6章では、行列がベクトルを受け取って新しいベクトルを返しました。
然し、実際のゲームで変換を一つだけ掛ける事は殆どありません。
キャラクターは拡大縮小され、回転され、ワールドに配置され、カメラから見られ、画面に投影されます。
頂点一つにつき、少なくとも四つか五つの行列です。
此の章では二つの行列を掛け合わせる方法を学びます。
其れによって、変換の連鎖全体を一つの行列にまとめる事が出来ます。
又、何故順番がそんなに大事なのかを見て、転置にも出会います。
転置は単純な「ひっくり返し」ですが、他の人の数式、本、シェーダーのコードを読むのに必要です。
7.1 考え方:一つずつ順番に
二つの行列とがあるとします。
ベクトルをまずで変換し、其の結果をで変換したいとします:
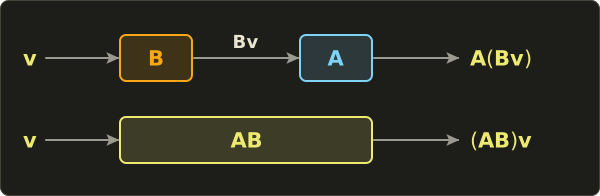
此れは行列とベクトルの積が二回です。
頂点一つなら問題ありません。
でも百万個の頂点を毎フレーム五つの行列に通すとなると、辛くなってきます。
全てのでとなる、両方の仕事を一度にこなす行列があれば便利ですよね。
其の行列は存在し、積と呼ばれます。
順番に注意して下さい。
と書きますが、先に起きるのはです。
ベクトルのすぐ隣に立っているのがだからです。
行列の積は右から左へ読みます。
7.2 公式
二つの行列との積の行列の要素は、Aのi行目とBのj列目の内積です:
2 × 2行列で全部書き出すと:
サイズのルールは第6章と同じで、右側の列が増えただけです:
内側の数字が一致する必要があり(の各行の長さとの各列の長さが同じ)、外側の数字が結果のサイズになります。
従って、2 × 3行列かける3 × 2行列は2 × 2行列になり、3 × 2行列かける2 × 3行列は3 × 3行列になります。
3 × 2かける3 × 2は定義されていません。
グラフィックスでは殆どの場合、同じサイズの正方行列同士(4 × 4かける4 × 4)を掛けるので、此のルールは簡単に満たせます。
7.3 仕組み
何故「行かける列」なのか?
第6章の一番大事な事を使って考えます。
行列の列は基底ベクトルの行き先でした。
積は、各基底ベクトルを「まず、次に」と同じ場所へ送らなければなりません。
はj番目の基底ベクトルをのj列目へ送ります。
其の列をと呼びましょう。
次にはをへ送ります。
従って、積のj列目はでなければなりません:
言葉で言うと、二つの行列を掛けるには、左の行列を右の行列の各列に掛ければ良いという事です。
そしての計算方法は第6章で知っています。
各成分はの行との内積です。
Aのi行目とBのj列目の内積、其れが公式です。
此の「列ごと」のイメージを覚えておいて下さい。
C++のコードは正に此の方法で計算します。
2 × 2の例
次の二つを掛けてみましょう:
計算する要素は四つで、の行との列の組み合わせ一つにつき一つです。
- Aの1行目とBの1列目:
- Aの1行目とBの2列目:
- Aの2行目とBの1列目:
- Aの2行目とBの2列目:
今度は逆の順番、です:
- Bの1行目とAの1列目:
- Bの1行目とAの2列目:
- Bの2行目とAの1列目:
- Bの2行目とAの2列目:
全く違います!
普通の数字ならですが、行列では一般にです。
此れを、行列の積は可換ではない(交換法則が成り立たない)と言います。
其れが図形的に何を意味するのかは7.4節で見ます。
3 × 3の例
第6章の行列をとして再利用し、新しいを選びます:
今回は要素が九つです。
の行は、、です。
の列は、、です。
Aの1行目とBの各列:
Aの2行目とBの各列:
Aの3行目とBの各列:
(を計算するとになり、やはり違います。)
本当に「Bの後にA」になっているか確かめる
の目的は、を掛けてからを掛けるのと同じ事をする事でした。
で確かめてみましょう。
遠回りの方法で、まずです。
第6章の見方2を使うと、はの列を全部足しただけです:
次にを1行ずつ:
近道の方法で、計算した積を使います(なので、こちらも列を足すだけです):
同じ答えです。
行列一つ、掛け算一回で、二回分と同じ結果になります。
7.4 順番が大事
何故とは違うのでしょうか?
「Bをしてから、Aをする」は「Aをしてから、Bをする」とは違う指示だからです。
靴下を履いてから靴を履くのと、靴を履いてから靴下を履くのは同じではありませんよね。
二つの簡単な2D変換で見てみましょう。
一つ目は、全てを横に2倍に引き伸ばします:
列を読むと、はへ行き、はのままです。
二つ目は反時計回りに4分の1回転、つまり90°の回転です。
回転の一般的な公式はまだ知りませんが(第8章で扱います)、必要ありません。
との行き先さえ分かれば良いのです。
を反時計回りに4分の1回転させると上を向き、になります。
を4分の1回転させると左を向き、になります。
此れが列です:
では二つの積です。
は「先に伸ばして、次に回す」です:
は「先に回して、次に伸ばす」です:
両方を単位正方形に掛けてみます。
では、角、、は、、へ行きます。
では、、、へ行きます。
左では、正方形がまず横長の2 × 1の長方形に伸ばされ、其れから横倒しに回されました。
今は幅1、高さ2で縦長に立っています。
右では、正方形がまず回され(まだ正方形のまま)、其れから横に伸ばされました。
今は幅2、高さ1で横長に寝ています。
同じ材料でも、順番が違えば結果が違います。
此れは、此れから書く全ての3Dプログラムで戦う事になる問題です。
第9章でモデル行列を作りますが、其の時に順番を間違えると何が起きるのか見る事になります。
覚えておくルールは一つ:ベクトルに一番近い行列が最初に起きる。
7.5 結合法則と単位行列
順番は大事ですが、括弧の付け方は関係ありません。
サイズが合う任意の三つの行列について:
此の性質を結合法則と呼びます。
考えてみれば当然です。
どちらも「Cをして、Bをして、Aをする」という意味で、どの二つを先にくっ付けるかを選んでいるだけです。
最後がベクトルでも同じで、です。
7.3節で数字を使って確かめたのは正に此れです。
結合法則こそが、グラフィックスが速い理由です。
ゲームの頂点はの様な連鎖を通ります(プロジェクション、ビュー、モデル。第9章から第12章で作ります)。
結合法則のお陰で、をCPUで一回だけ計算し、其の一つの行列を全ての頂点に使う事が許されます。
仕事の量を数えてみましょう。
4 × 4かける4 × 4の積は要素が16個で、其れぞれが長さ4の内積です。
従って掛け算は回、足し算は回です。
4 × 4行列かける4Dベクトルは、掛け算16回と足し算12回です。
頂点が百万個のメッシュでは:
| 方法 | 掛け算の回数 |
|---|---|
| 全ての頂点で | |
| を一回、其の後は頂点ごとに積一回 |
括弧を動かして良いというだけで、仕事が3分の1になりました。
そして数字の1と同じ様に、単位行列はどちら側から掛けても行列を変えません:
「何もしないで、Aをする」も「Aをして、何もしない」も、ただの「A」と同じです。
7.6 転置
行列の転置は、行列を対角線で裏返す事です。
行が列になり、列が行になります。
小さなTを付けてと書きます。
1行目のが1列目になり、2行目のが2列目になりました。
2 × 3行列は3 × 2行列になります。
対角成分(ここではと)はそのままの場所に残ります。
二回転置すると元に戻ります:。
列ベクトルを転置すると、1 × nの行列である行ベクトルになります:
6.5節を思い出して下さい。
片方が行優先で保存し、もう片方が列優先で読むと、読む側には丁度転置行列が見えます。
実際に転置に出会う場面の一つが此れです。
積の転置
一番大事なルールは此れです:
積の転置は、転置の積を逆の順番で掛けた物です。
2 × 2の例のとで確かめましょう。
なので、です。
もう片方は:
一致しました。
何故逆の順番になるのでしょうか?
の要素はの要素で、其れはAのj行目とBのi列目の内積です。
Aのj行目はのj列目で、Bのi列目はのi行目です。
つまり其れはのi行目とのj列目の内積、即ちの要素でもあります。
内積はどちらが左でも同じなので、二つは等しくなります。
他の人の数式を読む:行ベクトルの流儀
此のシリーズでは、ベクトルは列で、行列は左に立ちます:。
此れはOpenGL、GLSL、殆どの数学の本、多くのエンジンの流儀です(UnrealとDirectXMathは逆に行ベクトルを使います)。
然し、逆の流儀を使うコードや本も沢山あります。
ベクトルが行で、行列が右に立つ流儀で、と書きます。
昔のDirectX(D3DX数学ライブラリ)、多くのHLSLのコード、幾つかの有名なグラフィックスの本が此の流儀です。
どちらも間違いではありませんが、翻訳出来る必要があります。
あたし達の式の両辺を転置して、逆順のルールを使います:
従って、あちらの行列は単にあたし達の行列の転置、です。
先程のとで確かめます:
同じ数字で、片方は立っていて、片方は寝ているだけです。
実用上の結論は二つです:
- 連鎖が逆になる。 あたし達の(拡大縮小が最初)は、行ベクトルの流儀ではになります。DirectX風のコードが「vかける拡大縮小かける回転かける平行移動」と左から右へ読めるのは此の為です。
- 本に印刷された行列は裏返っている。 行ベクトルの本に載っている行列は、あたし達が書く行列の転置です。例えば、第9章で最後の列に入れる平行移動の数字は、其の様な本では最後の行に現れます。
ここには面白い偶然が隠れています。
行ベクトル流の行列はあたし達の行列の転置で、行優先の保存は列優先の保存の転置です。
二回裏返すと元に戻るので、行優先・行ベクトルの行列(DirectX風)は、列優先・列ベクトルの行列(OpenGL風)とメモリ上で全く同じバイト列になります。
シェーダーでは
3つのシェーディング言語全てで、どちら側からでも掛けられます:
- SlangとHLSLでは、
mul(M, v)はvを列として、mul(v, M)はvを行として扱います。従ってmul(v, M)はmul(transpose(M), v)と同じ結果になります。 - GLSLでは、
m * vはvを列として、v * mはvを行として扱います。従ってv * mはtranspose(m) * vと同じ結果になります。 - 3つの言語全てに組み込みの
transpose()関数があります。
mul(position, worldViewProj)と書いてあるシェーダーをコピーしたなら、其のシェーダーは行ベクトル流の行列を期待しています。
転置した行列を送るか、引数を入れ替えて下さい。
そして第6章を思い出して下さい。
SlangとHLSLでは行列同士の積もmul(A, B)で、決してA * Bではありません。
7.7 グラフィックスプログラミングでの使い方
モデル・ビュー・プロジェクションの連鎖
此れから書く全ての3D頂点シェーダーは、何らかの形で次の事をします:
- はモデル行列で、物体をワールドに配置します(第9章)。
- はビュー行列で、カメラが原点に来る様にワールドを動かします(第11章)。
- はプロジェクション行列で、ワールドの見える部分をGPUが描画する箱に押し込めます(第12章)。
右から左へ読みます。
モデルが最初、次にビュー、最後にプロジェクションです。
次は、三つの行列を別々に受け取って掛ける頂点シェーダーです。
括弧に注目して下さい。
行列を一つずつベクトルに掛けているので、行列とベクトルの積が三回です。
struct Matrices {
  float4x4 model;
  float4x4 view;
  float4x4 proj;
};

ConstantBuffer<Matrices> matrices;

struct VertexOutput {
  float4 position : SV_Position;
};

[shader("vertex")]
VertexOutput vertexMain(float3 position : POSITION) {
  VertexOutput output;
  float4 world = mul(matrices.model, float4(position, 1.0));
  float4 viewPos = mul(matrices.view, world);
  output.position = mul(matrices.proj, viewPos);
  return output;
}
#version 450
layout(set = 0, binding = 0) uniform Matrices {
mat4 model;
mat4 view;
mat4 proj;
};
layout(location = 0) in vec3 position;
void main() {
gl_Position = proj * (view * (model * vec4(position, 1.0)));
}struct Matrices {
float4x4 model;
float4x4 view;
float4x4 proj;
};
ConstantBuffer<Matrices> matrices;
struct VertexOutput {
float4 position : SV_Position;
};
VertexOutput vertexMain(float3 position : POSITION) {
VertexOutput output;
float4 world = mul(matrices.model, float4(position, 1.0));
float4 viewPos = mul(matrices.view, world);
output.position = mul(matrices.proj, viewPos);
return output;
}
何故GLSLで余分な括弧を付けているのでしょうか?
*は左から右へ計算されるので、proj * view * model * vは((proj * view) * model) * vという意味になります。
つまり実際の変換の前に、行列同士の積が二回(掛け算128回)、全ての頂点で行われます。
括弧を付ければ、行列とベクトルの積が三回(掛け算48回)で済みます。
結合法則によって結果は同じですが、コストは大きく違います。
一番良いのは、をCPUで一回計算して、第6章のmvpシェーダーの様に行列を一つだけ送る事です。
エンジンでは、ライティングにワールド座標が必要なのでmodelは別にしておき、proj * viewだけをフレームごとに一つのビュー・プロジェクション行列にまとめる事が良くあります。
シーングラフと階層構造
ゲームの中の物は、他の物にくっ付いています。
剣は手に握られ、手は前腕の先にあり、前腕は上腕からぶら下がり、上腕は体に付いています。
体が回転したら、くっ付いている物は全て一緒に回転するべきです。
コツは、各パーツが自分のローカル行列、つまり親に対してどう置かれているかだけを持つ事です。
ワールドでの行列は、親のワールド行列かける自分のローカル行列です:
展開すると、剣のワールド行列はです。
ここでも右から左へ読みます。
まず剣が手の中に置かれ、次に手が前腕に、という様に、最後は体がワールドに置かれます。
C++では木を上から下へ辿るだけです:
// Each frame, from the root down to the leaves.
Mat4 upperWorld = bodyWorld * upperLocal;
Mat4 foreWorld  = upperWorld * foreLocal;
Mat4 handWorld  = foreWorld * handLocal;
Mat4 swordWorld = handWorld * swordLocal;
foreLocalをアニメーションさせる(肘を曲げる)と、手と剣はforeWorldから計算されるので自動的に付いて来ます。
実際のローカル行列には位置のずれ(前腕は上腕の先から始まる)も含まれ、其れには第9章の平行移動が必要ですが、掛け算の連鎖は正に此の通りです。
UnityのTransform、GodotのNode3D、Unrealのシーンコンポーネント、glTFのノード階層は全て此の仕組みです。
CPUかGPUか?
大まかな目安は次の通りです:
- ドローコールの全ての頂点で同じ物(モデル、ビュー、プロジェクション、親の連鎖)は、CPUでフレームごと又は物体ごとに一回掛け合わせます。
- 頂点ごとに違う物はGPUで行います。頂点一つにつき行列とベクトルの積一回です。
小さな例外はスキニング(スケルタルアニメーション)で、各頂点が幾つかのボーン行列を混ぜます。
其れでも、ボーン行列自体(其れぞれが上の剣の様な長い連鎖)はCPUかコンピュートパスでまとめておき、頂点シェーダーは行列とベクトルの積を数回するだけです。
7.8 其の他の使い道
ロボット工学
ロボットアームは、上の剣の階層と同じです。
各関節は角度で決まる行列を持ち、グリッパーの位置は其れら全ての積です。
此の計算は順運動学と呼ばれ、文字通り行列の積の連鎖です。
グラフの経路を数える
小さな一方通行の道路網を考えます。
AからB、AからC、BからC、CからAへ道があります。
iからjへ道があれば、i行j列に1を書きます:
の要素はで、「iからkへ行き、kからjへ行ける」中継地点kの数を数えています。
つまりは、丁度二本の道を通るルートの数です。
Aの行を見ると、Aから二歩でA(A、C、A)とC(A、B、C)に行けますが、Bには行けません。
は三本の道のルートを数え、以下同様です。
SNS、ウェブクローラー、経路探索で此の考え方が使われています。
ニューラルネットワーク
ニューラルネットワークの層は、入力ベクトルを受け取ってを計算します。
は学習された重みの行列です(オフセットも加わりますが、ここでは無視します)。
二つの層を続けるとです。
結合法則により、此れは行列を持つ一つの層と同じです!
ニューラルネットワークが層の間に非線型な関数(例えば「負の数を0にする」)を挟むのは正に此の為です。
其れが無ければ、百層あっても一層と同じ力しかありません。
此れらのネットワークの学習と実行は殆どが巨大な行列の積で、だからこそグラフィックスの為に作られたGPUがAIの為の機械になったのです。
マルコフ連鎖を何歩も一度に
第6章では、天気の行列で今日から明日へ進み、二回掛けて明後日を求めました。
行列の積を使えば、二日分を一度に飛べます:
1列目のは、第6章で求めた「今日が晴れの時の二日後」と全く同じです。
を計算すれば、一ヶ月後の天気が分かります。
7.9 コード
次はlinalg.hhに書かれている通りの行列同士の積です:
// 行列×行列 / matrix × matrix (chapter 7)
inline Mat4 operator*(const Mat4 &a, const Mat4 &b) {
  Mat4 r;
  for (int i = 0; i < 4; ++i) r.c[i] = a * b.c[i];
  return r;
}
此れは7.3節の「列ごと」のイメージそのものです。
結果のi列目は、aかけるbのi列目です。
第6章の行列とベクトルのoperator*を再利用しているので、内積を一つも書く必要がありません。
そして転置です:
// 転置 / transpose (chapter 7)
inline Mat4 transpose(const Mat4 &m) {
  Mat4 r;
  for (int row = 0; row < 4; ++row)
    for (int col = 0; col < 4; ++col)
      r.at(row, col) = m.at(col, row);
  return r;
}
定義をそのままコードにした物です。
第6章のat()のお陰で、列優先のメモリについて考える必要は全くありません。
テストプログラム
7.3節の2 × 2行列を4 × 4単位行列の左上に入れて、積、転置、結合法則を確かめます。
printVec4とprintMat4は第6章と同じです。
#include "linalg.hh"
#include <cstdio>

void printVec4(const char *name, Vec4 v) {
  printf("%s = (%g, %g, %g, %g)\n", name, v.x, v.y, v.z, v.w);
}

void printMat4(const char *name, const Mat4 &m) {
  printf("%s =\n", name);
  for (int row = 0; row < 4; ++row) {
    printf("  [%6g %6g %6g %6g ]\n", m.at(row, 0), m.at(row, 1), m.at(row, 2), m.at(row, 3));
  }
}

int main() {
  // A and B from section 7.3, in the top-left corner of a 4x4 identity.
  Mat4 a = Mat4::identity();
  a.at(0, 0) = 1; a.at(0, 1) = 2;
  a.at(1, 0) = 3; a.at(1, 1) = 4;

  Mat4 b = Mat4::identity();
  b.at(0, 0) = 5; b.at(0, 1) = 6;
  b.at(1, 0) = 7; b.at(1, 1) = 8;

  printMat4("a * b", a * b);
  printMat4("b * a", b * a);
  printMat4("transpose(a)", transpose(a));

  // Composition: (a * b) * v gives the same as a * (b * v).
  Vec4 v = {1, 1, 0, 1};
  printVec4("(a * b) * v", (a * b) * v);
  printVec4("a * (b * v)", a * (b * v));
  return 0;
}
期待される出力:
a * b =
  [    19     22      0      0 ]
  [    43     50      0      0 ]
  [     0      0      1      0 ]
  [     0      0      0      1 ]
b * a =
  [    23     34      0      0 ]
  [    31     46      0      0 ]
  [     0      0      1      0 ]
  [     0      0      0      1 ]
transpose(a) =
  [     1      3      0      0 ]
  [     2      4      0      0 ]
  [     0      0      1      0 ]
  [     0      0      0      1 ]
(a * b) * v = (41, 93, 0, 1)
a * (b * v) = (41, 93, 0, 1)
左上の角は、手で計算したとと全く同じです。
単位行列のブロック同士を掛けると単位行列のブロックになるので、残りは単位行列のままです。
最後の二行について:をに掛けるとです。
、次にと一歩ずつ掛けても同じになります。
7.10 まとめ
- 積は「まずB、次にA」をする一つの行列です。積は右から左へ読みます。
- の要素は、Aのi行目とBのj列目の内積です。言い換えると、のj列目はAかけるBのj列目です。
- サイズ:(m × n)かける(n × p)は(m × p)になります。内側の数字が一致する必要があります。
- 行列の積は可換ではありません:一般に。拡大縮小してから回転するのと、回転してから拡大縮小するのは違います。
- 結合法則は成り立ちます:。だから百万個の頂点の為に行列を一つ前もって計算出来ます。
- 単位行列はどちら側から掛けても何も変えません:。
- 転置は行と列を入れ替え、です。
- 行ベクトルの流儀(、DirectX風)では、行列が転置され、連鎖が逆順になります。SlangとHLSLでは
mul(v, M)はmul(transpose(M), v)と同じです。 - グラフィックスでは:P V Mの連鎖、シーングラフ()、全ての頂点で共通の物はCPUでまとめる事。
7.11 課題
- ★ を計算し、次に同じ二つの行列を逆の順番で掛けて、答えが違う事を確かめて下さい。
- ★ 次の積のうち定義されている物はどれで、結果のサイズは幾つですか?(2 × 3)(3 × 4)、(3 × 2)(3 × 2)、(1 × 3)(3 × 1)、(3 × 1)(1 × 3)。
- ★ 、について、とを計算し、等しい事を確かめて下さい。次にを計算し、等しくない事を見て下さい。
- ★ 7.4節の90°回転を使ってを計算して下さい。iとjはどこへ行きますか?其れは何度の回転ですか?
- ★★ z軸周りの90°回転を、列を設定して
Mat4として作って下さい(c[0] = {0, 1, 0, 0}、c[1] = {-1, 0, 0, 0}、残りは単位行列)。r * r * r * rを出力すると単位行列になるはずです。次にs.at(0, 0) = 2とした拡大縮小sを作り、(r * s) * Vec4{1, 0, 0, 0}と(s * r) * Vec4{1, 0, 0, 0}を出力して下さい。(0, 2, 0, 0)と(0, 1, 0, 0)になれば正解です。 - ★★
vを行ベクトルとして扱うVec4 mulRow(Vec4 v, const Mat4 &m)を書いて下さい(結果のj番目の成分はvとmのj列目の内積)。第6章のテストプログラムの行列とv = {2, 1, 3, 1}で試すと(14, 5, 6, 1)になり、transpose(m) * vも同じ結果を出力するはずです。 - ★★★ DirectX時代の本が、行ベクトルを使って頂点の変換をと書いています(添字bは本の行列という意味です)。此れを、あたし達の行列、、を使って此のシリーズの流儀に書き直して下さい。又、何故文字の順番が逆になるのか、そして何故二つの流儀でメモリ上のバイト列が同じになり得るのかを説明して下さい。
コメント(0)
まだコメントはありません。
ログインするとコメント出来ます。